
Hardware für lokale LLMs: Was es gibt, was es kostet und was es leistet (Stand November 2026)
Artikel-Übersicht
Wer ein Sprachmodell auf eigener Hardware betreiben will, steht im November 2026 vor einer seltsamen Lage: Die Modelle waren nie so gut, die Hardware war nie so teuer. Ein offenes Modell mit 27 Milliarden Parametern schreibt heute Code auf einem Niveau, für das man vor einem Jahr eine Cloud-API brauchte. Gleichzeitig kostet die Grafikkarte, auf der es am schnellsten läuft, im Handel fast das Vierfache ihrer Preisempfehlung.
Dieser Artikel ordnet beides zusammen. Er erklärt, welche zwei technischen Werte über Tauglichkeit und Tempo entscheiden, welche offenen Modelle derzeit vorn liegen, welche Hardwareklassen es gibt und was sie heute in Deutschland kosten – und vor allem, was du an Output erwarten kannst. Die Leistungswerte stammen aus veröffentlichten Messreihen (llama.cpp-Benchmarks, Hardware Corner, LMSYS, c't 3003), die Preise aus dem heise-Preisvergleich und den Herstellershops, alles abgerufen am 12. November 2026.
Eigene Messwerte von einer RTX 4090, den Vergleich Ollama gegen vLLM und die Wirkung von Treiber und KV-Cache findest du in Lokale LLMs auf der RTX 4090. Welches konkrete Ollama-Modell zu deiner vorhandenen Hardware passt, beantwortet Welches Ollama-Modell?. Hier geht es um die Frage davor: Was kaufe ich?
Die kurze Antwort
Für die meisten Entwickler ist Qwen3.8-27B das beste lokal betreibbare Modell, und dafür reichen 24 bis 32 GB Grafikspeicher oder 48 bis 64 GB geteilter Speicher. Wer mehr will – größere MoE-Modelle mit 100 Milliarden Parametern und mehr –, braucht 128 GB geteilten Speicher, also einen Strix-Halo-Rechner, einen DGX Spark oder einen Mac Studio.
Die Faustregeln:
- Speicher entscheidet, was läuft. Das Modell plus Kontext muss komplett hineinpassen.
- Bandbreite entscheidet, wie schnell es antwortet. Eine RTX 4090 liest knapp viermal so schnell aus dem Speicher wie ein DGX Spark.
- Rechenleistung entscheidet, wie schnell es liest. Lange Prompts – Coding-Agenten, RAG – verarbeiten NVIDIA-Karten um ein Vielfaches schneller als Macs und Strix Halo.
- MoE-Modelle verschieben die Rechnung. Sie brauchen viel Speicher, sind aber schnell, weil pro Token nur ein kleiner Teil der Gewichte gelesen wird.
- Warten bringt derzeit nichts. Die Speicherpreise steigen weiter.
Worauf es bei der Hardware ankommt
Ein Sprachmodell erzeugt jedes Token, indem es alle aktiven Gewichte einmal aus dem Speicher liest. Die Ausgabegeschwindigkeit ist deshalb nach oben durch die Speicherbandbreite begrenzt, geteilt durch die Datenmenge pro Token. Das gilt für jede Plattform und erlaubt eine schnelle Abschätzung, bevor du Geld ausgibst:
def obergrenze_tok_s(bandbreite_gb_s: float, gelesen_gb_pro_token: float) -> float:
    """Theoretische Obergrenze der Generierung. Real erreichst du 60 bis 85 Prozent."""
    return bandbreite_gb_s / gelesen_gb_pro_token

# Dichtes 27B-Modell in 4 Bit: rund 16,7 GB pro Token
print(obergrenze_tok_s(1008, 16.7))   # RTX 4090      -> ~60 tok/s, gemessen 46 bis 51
print(obergrenze_tok_s(273, 16.7))    # DGX Spark     -> ~16 tok/s, gemessen 12

# MoE-Modell mit ~3 Mrd. aktiven Parametern in 4 Bit: rund 2 GB pro Token
print(obergrenze_tok_s(273, 2.0))     # DGX Spark     -> ~136 tok/s, gemessen 58
Beim MoE-Modell liegt die Messung weiter unter der Obergrenze, weil Routing, Attention und KV-Cache zusätzlich Bandbreite und Rechenzeit kosten. Die Richtung stimmt trotzdem: Bei MoE-Modellen werden langsame Speichersysteme wieder brauchbar.
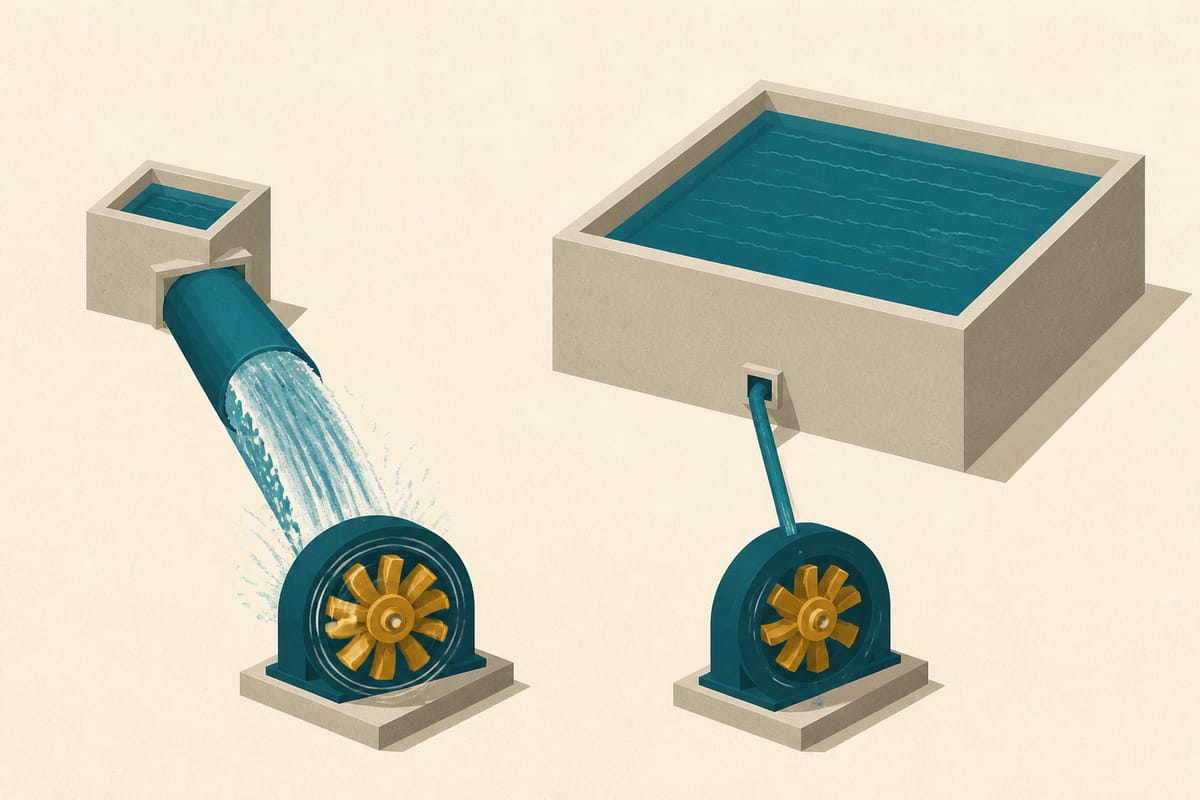
Zwei Wasserbecken nebeneinander. Links ein kleines Becken mit einem sehr dicken Rohr, aus dem ein kräftiger Strahl auf eine Turbine schießt. Rechts ein riesiges Becken mit einem dünnen Rohr, aus dem nur ein schmales Rinnsal auf eine gleich große Turbine fällt.
Speichermenge und Bandbreite sind zwei verschiedene Dinge: Eine Grafikkarte ist das kleine Becken mit dem dicken Rohr, ein System mit 128 GB geteiltem Speicher das große Becken mit dem dünnen. Wie schnell die Turbine dreht, entscheidet das Rohr.
Drei Werte bestimmen also die Kaufentscheidung:
| Wert | bestimmt | typische Spanne |
|---|---|---|
| Speichermenge | welches Modell mit wie viel Kontext lädt | 16 GB (Gaming-GPU) bis 512 GB (Mac Studio) |
| Speicherbandbreite | Geschwindigkeit der Ausgabe (Decode) | 256 GB/s (Strix Halo) bis 1.792 GB/s (RTX 5090) |
| Rechenleistung | Geschwindigkeit der Prompt-Verarbeitung (Prefill) | Faktor 10 zwischen NVIDIA-Workstation und Mac/Strix Halo |
Der dritte Punkt wird beim Kauf gern übersehen. Ein Chat mit kurzen Fragen merkt vom Prefill wenig. Ein Coding-Agent, der bei jedem Schritt 30.000 Token Kontext mitschickt, merkt es sehr wohl. Dazu weiter unten mehr.
Wie viel Speicher ein Modell in welcher Quantisierung belegt und warum Q4_K_M meist der richtige Kompromiss ist, erkläre ich in Quantisierung von LLMs erklärt. Als grobe Rechnung: Parameter in Milliarden mal 0,6 ergibt GB bei 4 Bit, plus einige GB für den Kontext.
Die Preislage: Speicherkrise statt Preisverfall
Hardware mit viel schnellem Speicher kostet im November 2026 ein Vielfaches dessen, was sie vor einem Jahr gekostet hat – und eine Entspannung ist nicht in Sicht. Der Grund ist der Speicher selbst: Die Hersteller lenken ihre Kapazität in Server-DRAM und HBM für KI-Rechenzentren, für Grafikkarten und Desktop-RAM bleibt weniger.
Die Zahlen dazu:
- Der Grafikkarten-Preisindex von 3DCenter stieg von 102 Prozent im November 2025 auf 165 Prozent im Oktober 2026, der DDR5-Index im selben Zeitraum von 178 auf 559 Prozent.
- Die RTX 5090 hat eine deutsche Preisempfehlung von 2.099 Euro. Laut Hardwareluxx lag sie im April bei rund 3.500 Euro, im Oktober bei 6.149 Euro. Am 12. November war das günstigste Angebot 7.828,50 Euro.
- AMD hat die Preise für seine Grafikkarten-Kits laut PC Games Hardware am 1. August und am 1. Oktober um je rund 10 Prozent erhöht, GDDR6 kostet am Spotmarkt etwa das Dreifache von Ende 2025.
- TrendForce erwartet für das vierte Quartal 2026 weitere 10 bis 15 Prozent Aufschlag bei konventionellem DRAM.
- Der DGX Spark startete mit 3.999 US-Dollar, NVIDIA erhöhte im Februar auf 4.699 Dollar.
Auch der Gebrauchtmarkt fängt das nicht auf. PC Games Hardware stellt fest, dass der übliche Preisvorteil gebrauchter High-End-Karten in der Speicherkrise weitgehend verschwunden ist. c't 3003 nennt für die RTX 4090 am 6. November gebraucht rund 4.000 Euro, neu rund 5.000 Euro – bei einer Preisempfehlung von 1.769 Euro zum Start.
Gerüchte über eine RTX 5080 mit 24 GB für Dezember oder Januar gibt es, NVIDIA hat aber nichts angekündigt, und laut TweakTown soll der Termin wegen der teuren 3-GB-GDDR7-Chips schon wieder gestrichen sein. Wer jetzt etwas braucht, sollte nicht auf ein Produkt warten, das es nicht gibt.
Welche Modelle sich lohnen
Die stärksten offenen Modelle sind Billionen-Parameter-Riesen für Rechenzentren. Das stärkste Modell, das auf eine einzelne Grafikkarte passt, ist Qwen3.8-27B. Den besten Überblick gibt der Intelligence Index von Artificial Analysis. Seit dem 27. Oktober 2026 gilt dort Version 5, die deutlich strenger bewertet als Version 4; die Werte sind mit älteren nicht vergleichbar.
| Rang (offene Modelle) | Modell | Index v5 | Parameter gesamt / aktiv | lokal realistisch? |
|---|---|---|---|---|
| 1 | Kimi K3.1 Pro | 46 | 2,8 Bio. / 104 Mrd. | nein |
| 2 | DeepSeek V4.1 Flash | 33 | 552 / 16 Mrd. | nur Mac Studio 512 GB oder Server |
| 3 | GLM-5.3 | 32 | 753 / 40 Mrd. | nur Mac Studio 512 GB oder Server |
| 6 | Mistral Large 4 | 26 | 1,1 Bio. / 52 Mrd. | nein |
| 7 | Qwen3.8 27B | 20 | 27 Mrd. dicht | ja, ab 24 GB |
| 10 | Nemotron 3.5 Super VL | 14 | 120 / 12 Mrd. | ab 96 bis 128 GB |
Zum Vergleich: Das beste proprietäre Modell im selben Index, Claude Fable 5.2, steht bei 65. c't 3003 schätzt den Rückstand lokaler Modelle auf die Cloud-Spitze auf etwa ein halbes Jahr.
Die Empfehlungen nach Speicherklasse
| verfügbarer Speicher | Modell | Typ | Dateigröße (Q4) | Lizenz |
|---|---|---|---|---|
| 8 bis 16 GB | Gemma 4 12B | dicht, multimodal | 8,0 GB | Apache 2.0 |
| 8 bis 16 GB | Qwen3.5 9B | dicht | 6,6 GB | Apache 2.0 |
| 24 bis 32 GB | Qwen3.8-27B | dicht, multimodal | 17,4 GB | Apache 2.0 |
| 24 bis 32 GB | Qwen3.6-35B-A3B | MoE, 3 Mrd. aktiv | 24 GB | – |
| 24 bis 32 GB | Gemma 4 26B-A4B | MoE, 4 Mrd. aktiv | 18 GB | Apache 2.0 |
| 64 bis 128 GB | Qwen3.8-Flash-Next | MoE, 125 / 6 Mrd. | siehe Text | qwen-community-1.0 |
| 64 bis 128 GB | gpt-oss-120b | MoE | 65 GB | Apache 2.0 |
| 96 bis 128 GB | Nemotron 3.5 Super VL | MoE, 120 / 12 Mrd. | 86,9 GB | – |
| 256 bis 512 GB | GLM-5.3 | MoE, 753 / 40 Mrd. | 467 GB (Q4), 239 GB (2 Bit) | eigene Lizenz |
Die Dateigrößen stammen aus der Ollama-Bibliothek und den GGUF-Repositories von bartowski und unsloth. Ein Strich in der Lizenzspalte heißt, dass ich den Lizenztext nicht selbst geprüft habe.
Qwen3.8-27B ist seit dem 14. August 2026 verfügbar und gilt in der Fachpresse als Standardempfehlung: c't 3003 nennt es am 6. November das relevanteste lokale Modell für Rechner unter 8.000 Euro, vor allem fürs Coding. Was es im Vergleich mit Cloud-Modellen leistet, steht ausführlich in Qwen3.8-27B gegen die Cloud. Mit 16 GB Grafikspeicher läuft es nur in 3 Bit (UD-Q3_K_XL); in 4 Bit bleibt dort laut c't kaum Platz für mehr als 8.000 Token Kontext.
Qwen3.8-Flash-Next ist die Wahl für 64 bis 128 GB. Laut Modellkarte hat es 125 Milliarden Gewichte, davon rund 6 Milliarden aktiv, plus 51 Milliarden N-Gramm-Embeddings und 4 Milliarden für Multi-Token-Prediction. In den Herstellerbenchmarks liegt es vor dem 27B, etwa bei SWE-bench Multilingual (81,0 gegen 73,8). c't 3003 bleibt trotzdem beim 27B als Standard, weil Flash-Next sich gelegentlich in Schleifen verfängt. Die Lizenz heißt „qwen-community-1.0" und ist nicht Apache 2.0 – vor einem kommerziellen Einsatz solltest du den Text lesen.
Für deutschsprachige Texte gibt es eigene Gesichtspunkte; die behandelt Ollama auf Deutsch. Das in Deutschland trainierte Kolibri 1 von Aleph Alpha braucht mit 78 Milliarden Parametern ebenfalls die 64-GB-Klasse, Details in Kolibri 1 von Aleph Alpha.
Die Hardwareklassen und ihre Preise
Lokale LLM-Hardware zerfällt in zwei Lager: Grafikkarten mit wenig, aber sehr schnellem Speicher und Systeme mit viel, aber langsamerem geteiltem Speicher. Dazwischen steht die RTX PRO 6000 mit 96 GB, die beides kann – zu einem Preis, der sie für Privatleute aus dem Rennen nimmt.
Alle Preise: günstigstes Angebot im heise-Preisvergleich bzw. Herstellershop am 12. November 2026, sofern nicht anders angegeben.
| System | Speicher für das Modell | Bandbreite | Preis ab |
|---|---|---|---|
| NVIDIA RTX 5060 Ti 16 GB | 16 GB | 448 GB/s | 735 € |
| AMD Radeon RX 9070 XT | 16 GB | 640 GB/s | 875 € |
| Intel Arc Pro B60 | 24 GB | 456 GB/s | 889 € |
| NVIDIA RTX 5070 Ti | 16 GB | 896 GB/s | 1.334 € |
| NVIDIA RTX 5080 | 16 GB | 960 GB/s | 1.675 € |
| Intel Arc Pro B70 | 32 GB | – | nicht unter 1.700 € (c't, 6.11.) |
| AMD Radeon AI PRO R9700 | 32 GB | 644 GB/s | 2.023 € |
| NVIDIA RTX 4090 | 24 GB | 1.008 GB/s | gebraucht um 4.000 €, neu um 5.000 € (c't, 6.11.) |
| NVIDIA RTX 5090 | 32 GB | 1.792 GB/s | 7.829 € |
| NVIDIA RTX PRO 6000 Blackwell | 96 GB | 1.792 GB/s | 17.779 € |
| AMD Ryzen AI Max+ 395 (Strix Halo) | 128 GB geteilt | 256 GB/s | 3.889 € (Framework, ausverkauft), 3.900 € (GMKtec EVO-X2) |
| NVIDIA DGX Spark und GB10-Partnergeräte | 128 GB geteilt | 273 GB/s | 5.699 € (Lenovo ThinkStation PGX) |
| Apple Mac mini M5 Pro | 64 GB geteilt | 307 GB/s | 3.184 € (Handel, 7.11.) |
| Apple Mac Studio M5 Max | 64 bzw. 128 GB geteilt | 614 GB/s | 3.659 € mit 64 GB |
| Apple Mac Studio M5 Ultra | 96 GB geteilt | 1.200 GB/s | 6.599 € |
| Apple Mac Studio M5 Ultra | 256 GB geteilt | 1.200 GB/s | 10.999 € |
| Apple Mac Studio M5 Ultra | 512 GB geteilt | 1.200 GB/s | 25.079 € |
Bei den Systemen mit geteiltem Speicher steht nicht der ganze Speicher für das Modell bereit; Betriebssystem und Anwendungen brauchen ihren Teil. Den Preis für den Mac Studio M5 Max mit 128 GB konnte ich im Apple Store nicht verlässlich auslesen.
Grafikkarten mit 16 GB: der Einstieg
Mit 16 GB laufen kleine Modelle bis etwa 14 Milliarden Parameter gut und Qwen3.8-27B nur mit Abstrichen. Die RTX 5060 Ti 16 GB ist mit 735 Euro der günstigste Einstieg, ihre schmale Speicheranbindung (448 GB/s) macht sie aber langsam. Die RX 9070 XT hat mehr Bandbreite und kam bei c't 3003 mit Qwen3.8-27B auf 34,4 Token pro Sekunde – bei nur rund 8.000 Token Kontext. RTX 5070 Ti und 5080 sind schneller, haben aber ebenfalls nur 16 GB und sind für LLMs ihr Geld kaum wert.
24 bis 32 GB: die Klasse für Qwen3.8-27B
Das ist die Klasse, in der sich für Entwickler der Kauf am ehesten rechnet. Die interessanten Kandidaten:
- Intel Arc Pro B60 (24 GB, 889 €) ist die günstigste Karte mit 24 GB. Die Bandbreite ist halb so hoch wie bei einer RTX 4090, und die Software (SYCL-Backend von llama.cpp, vLLM-XPU) ist weniger ausgereift als CUDA. Für ein MoE-Modell der 30B-Klasse reicht es trotzdem gut, siehe Messwerte unten.
- AMD Radeon AI PRO R9700 (32 GB, 2.023 €) bringt 32 GB zu einem Viertel des Preises einer RTX 5090. Unter llama.cpp mit Vulkan läuft sie inzwischen ordentlich.
- RTX 3090 und 4090 waren lange die Vernunftwahl. Zu den aktuellen Preisen ist das vorbei: Eine generalüberholte 3090 kostet laut gpuprix bei Amazon ab 2.499 Euro, eine 4090 rund 4.000 bis 5.000 Euro.
- RTX 5090 (32 GB, 7.829 €) ist die schnellste Consumer-Karte, mit fast doppelter Bandbreite der 4090. Zum Straßenpreis ist sie für LLMs schwer zu rechtfertigen.
96 GB auf einer Karte: RTX PRO 6000
Die RTX PRO 6000 Blackwell ist das einzige Einzelgerät, das viel Speicher mit voller Grafikkarten-Bandbreite kombiniert. 96 GB, 1.792 GB/s, 600 Watt. Laut ComputerBase lag sie Anfang Juni noch bei knapp 13.000 Euro, inzwischen ab 17.779 Euro. Für Firmen, die gpt-oss-120b, Nemotron 3.5 Super oder Qwen3.8-Flash-Next schnell und für mehrere Nutzer betreiben wollen, ist sie die naheliegende Wahl. Für Privatleute nicht. Die kleinere RTX PRO 5000 mit 48 GB kostet ab 8.300 Euro.
Geteilter Speicher: Strix Halo, DGX Spark und Mac
Diese Systeme sind die Wahl, wenn das Modell schlicht nicht in 32 GB passt. Sie unterscheiden sich stark in Bandbreite, Prefill-Leistung und Software:
- Strix Halo (Ryzen AI Max+ 395, 128 GB) ist mit rund 3.900 Euro der günstigste Weg zu 128 GB. Die Bandbreite ist die niedrigste der Klasse, der Prefill schwach. Mit MoE-Modellen ist er trotzdem brauchbar. Der Nachfolger Ryzen AI Max+ PRO 495 bringt bis zu 192 GB; Framework nimmt dafür Vorbestellungen ab 7.659 Euro an.
- DGX Spark und die GB10-Geräte von ASUS, Dell, Lenovo, MSI, Gigabyte, Acer und HP haben kaum mehr Bandbreite als Strix Halo, aber eine NVIDIA-GPU mit CUDA. Das bringt einen deutlich besseren Prefill und volle Kompatibilität mit vLLM und SGLang. Seit dem 23. Oktober gibt es eine Variante mit 64 GB ab 4.999 US-Dollar; in Deutschland ist sie mit 6.199 Euro (ASUS) teils teurer als die 128-GB-Geräte.
- Mac Studio M5 Max liegt mit 614 GB/s mehr als doppelt so hoch wie Spark und Strix Halo. Der M5 Ultra schafft 1.200 GB/s und ist mit bis zu 512 GB das einzige Desktop-System, auf dem Modelle wie GLM-5.3 in 4 Bit laufen. Die M5-Generation hat beim Prefill gegenüber M3 und M4 kräftig zugelegt. Die Lieferzeiten sind lang: laut ComputerBase Mitte Dezember für die 96-GB-Version, 13 bis 15 Wochen für 256 GB.
- Mac mini M5 Pro mit 64 GB ist der günstigste Mac mit genug Speicher für Qwen3.8-27B und langen Kontext. c't 3003 empfiehlt bei geteiltem Speicher mindestens 48 GB.
Neu sind außerdem Notebooks mit NVIDIAs RTX Spark (N1X) und bis zu 128 GB geteiltem Speicher. Im deutschen Handel gab es am 12. November aber nur Konfigurationen bis 64 GB, ab 4.075 Euro.
Was du an Output erwarten kannst
Mit Qwen3.8-27B in 4 Bit liegt eine RTX 4090 bei rund 46 bis 51 Token pro Sekunde, ein M5 Max mit 128 GB bei 31, ein DGX Spark und ein Strix Halo bei 12 bis 13. Zum Einordnen: Ab etwa 20 Token pro Sekunde liest sich ein Chat flüssig, für einen Coding-Agenten, der viel Text erzeugt, sind 40 und mehr deutlich angenehmer.
Das dichte Referenzmodell: Qwen3.8-27B
| Hardware | Generierung bei 4k Kontext | Prefill bei 4k Kontext | Quelle |
|---|---|---|---|
| RTX 5090 | 74,8 tok/s | 3.750 tok/s | Hardware Corner, Aug. 2026 |
| RTX 4090 | 46,2 tok/s (c't: 51,1) | 2.963 tok/s | Hardware Corner, Aug. 2026; c't 3003, Nov. 2026 |
| RTX 3090 | 40,3 tok/s | 1.308 tok/s | Hardware Corner, Aug. 2026 |
| RX 9070 XT | 34,4 tok/s (nur ~8k Kontext) | – | c't 3003, Nov. 2026 |
| Apple M5 Max (128 GB) | 31,4 tok/s | 834 tok/s | Hardware Corner, Aug. 2026 |
| 2× RTX 5060 Ti | 22,5 tok/s | 1.168 tok/s | Hardware Corner, Aug. 2026 |
| Strix Halo | 13,3 tok/s | – | c't 3003, Nov. 2026 |
| GB10 (Dell Pro Max) | 12,2 tok/s | 813 tok/s | Hardware Corner, Aug. 2026 |
Hardware Corner hat mit llama.cpp und Q4_K_S gemessen, c't 3003 mit llama-bench und Q4_K_M. Den Mac Studio M5 Ultra sieht c't etwa gleichauf mit der RTX 4090, ohne eine Zahl zu nennen.
Zwei Dinge verändern diese Werte erheblich. Spekulatives Decoding hebt den Strix Halo laut c't beim Code-Schreiben auf über 40 Token pro Sekunde – das Modell rät mehrere Token voraus und lässt sie in einem Durchgang prüfen. Auf meiner RTX 4090 brachte das MTP-Modul von Qwen3.8-27B Faktor 1,55. Und langer Kontext bremst: Bei 64.000 Token im Kontext fällt die 4090 auf 38,4 Token pro Sekunde, der M5 Max auf 18,2, das GB10-System auf 9,7.
MoE-Modelle: der eigentliche Hebel
Ein MoE-Modell mit wenigen aktiven Parametern ist auf jeder Hardware um ein Mehrfaches schneller als ein dichtes Modell ähnlicher Qualität. Das macht die Systeme mit geteiltem Speicher erst interessant:
| Hardware | Modell | Generierung | Prefill | Quelle |
|---|---|---|---|---|
| RTX 5090 | Qwen3.5-35B-A3B (Q4) | 194 tok/s | 7.026 tok/s | llama.cpp #19890, Feb. 2026 |
| Radeon AI PRO R9700 | Qwen3.5-35B-A3B (Q4) | 127 bis 163 tok/s | 2.713 tok/s | llama.cpp #19890, Feb.–Apr. 2026 |
| Arc Pro B60 | Qwen3-Coder-30B-A3B (Q4) | 82,4 tok/s | – | ninabot.ch, Sep. 2026 |
| Strix Halo | Qwen3.6-35B-A3B (Q4_K_M) | 63,1 tok/s | 1.018 tok/s | zenn.dev, Jun. 2026 |
| DGX Spark | Qwen3.5-35B-A3B (MXFP4) | 58,0 tok/s | 2.828 tok/s | nabe2030, Apr. 2026 |
| RTX PRO 6000 | gpt-oss-120b (MXFP4) | 196 tok/s | 5.518 tok/s | llama.cpp #15396, Aug. 2025 |
| Mac Studio M3 Ultra | gpt-oss-120b | 78,4 tok/s | 1.286 tok/s | Jeff Geerling, Dez. 2025 |
| DGX Spark | gpt-oss-120b (MXFP4) | 60,6 tok/s | 1.956 tok/s | llama.cpp #16578, Nov. 2025 |
| Strix Halo | gpt-oss-120b (MXFP4) | 47,5 bis 54,5 tok/s | 459 bis 1.000 tok/s | llama.cpp #16578; zenn.dev |
| Mac Studio M3 Ultra | Qwen3-235B-A22B (Q4_K_M) | 26,4 tok/s | 349 tok/s | Jeff Geerling, Dez. 2025 |
| Mac Studio M3 Ultra | DeepSeek-R1 671B (Q4_K_M) | 19,9 tok/s | 166 tok/s | Jeff Geerling, Dez. 2025 |
Für die M5-Generation des Mac Studio und für die ganz neuen Großmodelle wie GLM-5.3 habe ich keine belastbaren Messreihen gefunden; die M3-Ultra-Werte sind eine Untergrenze. Zum Vergleich der dichten Bauweise: Llama 3.3 70B schafft auf derselben RTX PRO 6000 nur 34 Token pro Sekunde, auf dem M3 Ultra 14 und auf Strix Halo rund 5.
Einen Sonderweg zeigt die iX in ihrer Ausgabe 12/2026: Mit der quelloffenen Engine Strata, die die meistgenutzten Experten im Grafikspeicher hält und den Rest in RAM und SSD auslagert, lief Qwen3.8-Flash-Next auf einem PC mit RTX 5090 mit 135 bis 145 Token pro Sekunde, auf einem Mac Studio M2 Ultra mit 49 bis 58. Als Untergrenze nennt die iX 12 GB Grafikspeicher und 32 GB RAM. Das ist eine einzelne Testreihe – aber ein Hinweis, dass große MoE-Modelle nicht zwingend 128 GB am Stück brauchen.
Der Prefill: wo Macs und Strix Halo zurückfallen
Bei langen Prompts liegen zwischen einer NVIDIA-Karte und einem System mit geteiltem Speicher nicht Prozente, sondern eine Größenordnung. Bei Llama 3.3 70B verarbeitet die RTX PRO 6000 rund 1.800 Token pro Sekunde, der M3 Ultra 160, Strix Halo 77 bis 122. Bei der Generierung trennt PRO 6000 und M3 Ultra dagegen nur gut Faktor 2.
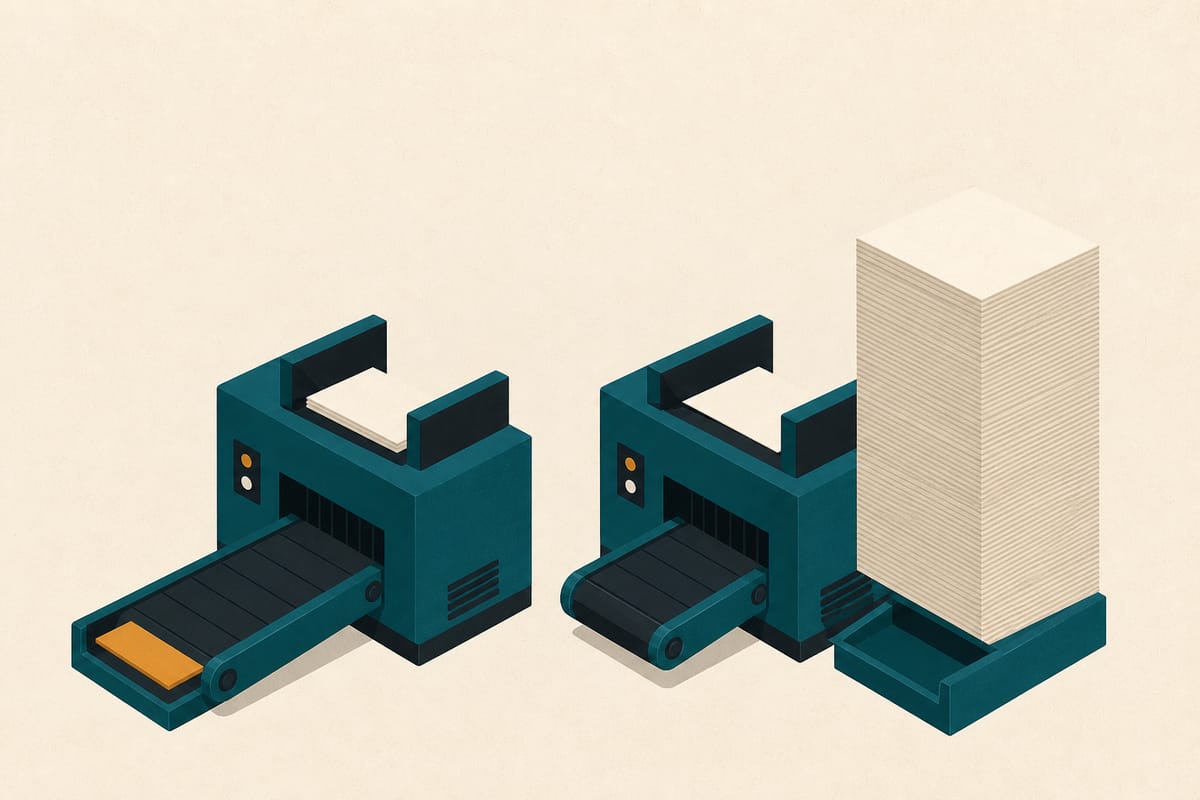
Zwei gleiche Maschinen, die Papier einziehen. Vor der linken ist der Stapel fast abgearbeitet, im Ausgabefach liegt schon eine fertige orangefarbene Karte. Vor der rechten steht noch ein hoher, kaum angetasteter Papierstapel, ihr Ausgabefach ist leer.
Prefill ist das Einlesen des Prompts, bevor das erste Wort der Antwort entsteht. Bei langen Prompts ist eine NVIDIA-Karte damit längst fertig, während ein Mac oder Strix-Halo-Rechner noch am Stapel arbeitet.
Praktisch bedeutet das: Ein Coding-Agent, der 32.000 Token Kontext mitschickt, wartet auf dem M3 Ultra über drei Minuten auf das erste Token, auf der PRO 6000 unter 20 Sekunden. c't 3003 hat es mit Qwen3.8-27B und rund 4.000 Token gemessen: eine Sekunde auf der RTX 4090, vier Sekunden auf dem M5 Ultra.
Die M5-Generation holt auf. Im Apple-Silicon-Referenztest von llama.cpp (Llama 2 7B, 4 Bit) verarbeitet ein M5 Max mit 40 GPU-Kernen 3.220 Token pro Sekunde Prompt, ein M4 Max mit ebenfalls 40 Kernen 886. Apple selbst gibt für den M5 Ultra gegenüber dem M3 Ultra eine bis zu 4,6-fach kürzere Zeit bis zum ersten Token an. Der DGX Spark ist trotz geringer Bandbreite beim Prefill stark, weil die GB10-GPU viel Rechenleistung hat.
Mehrere Nutzer
Für ein Team zählt der Gesamtdurchsatz, und den liefert nur eine Laufzeitumgebung mit Batching wie vLLM oder SGLang. Auf dem DGX Spark stieg der Durchsatz eines 8B-Modells laut LMSYS von 20,5 Token pro Sekunde bei einer Anfrage auf 368 bei 32 parallelen Anfragen. Vier Arc Pro B60 schafften mit Qwen3.8-27B unter vLLM bei 64 Anfragen 685 Token pro Sekunde insgesamt, pro Anfrage aber nur noch 12. Wie groß der Unterschied zwischen Ollama und vLLM unter Last ist, habe ich auf der RTX 4090 gemessen: Faktor 4,3 bei acht parallelen Anfragen.
Empfehlungen nach Budget
Die beste Hardware ist die, deren Speicher zu dem Modell passt, das du nutzen willst – nicht die mit dem höchsten Benchmark. Darum zuerst die Frage, was laufen soll, dann das Budget:
| Budget | Empfehlung | was damit läuft | was du erwarten kannst |
|---|---|---|---|
| unter 1.000 € | Arc Pro B60 (24 GB) oder vorhandene 16-GB-Karte | Qwen3.8-27B in 4 Bit (B60), MoE der 30B-Klasse, Gemma 4 12B | 80 tok/s mit MoE auf der B60; dichtes 27B deutlich langsamer |
| 2.000 bis 4.000 € | Radeon AI PRO R9700 (32 GB) oder Strix Halo (128 GB) oder Mac mini M5 Pro (64 GB) | R9700: Qwen3.8-27B mit langem Kontext; Strix Halo: zusätzlich gpt-oss-120b, Flash-Next | R9700: über 120 tok/s mit MoE; Strix Halo: ~13 tok/s dicht, 50 bis 60 mit MoE, schwacher Prefill |
| 4.000 bis 7.000 € | Mac Studio M5 Max (128 GB), DGX Spark (128 GB) oder Mac Studio M5 Ultra (96 GB) | MoE bis 120 Mrd. Parameter | Spark: guter Prefill, CUDA, ~60 tok/s mit gpt-oss-120b; Mac: höhere Bandbreite, ruhig und sparsam |
| 7.000 bis 11.000 € | RTX 5090 oder Mac Studio M5 Ultra (256 GB) | 5090: alles bis 32 GB, sehr schnell; Ultra: Modelle bis ~200 Mrd. Parameter | 5090: ~75 tok/s dicht, ~190 mit MoE |
| ab 17.000 € | RTX PRO 6000 oder Mac Studio M5 Ultra (512 GB) | PRO 6000: 120B-MoE für ein Team; Ultra 512 GB: GLM-5.3, DeepSeek V4.1 Flash | PRO 6000: ~200 tok/s mit gpt-oss-120b |
Ein paar Abwägungen, die in der Tabelle keinen Platz haben:
- NVIDIA oder nicht? CUDA ist bei vLLM, SGLang und neuen Modellen immer zuerst unterstützt. AMD und Intel laufen unter llama.cpp gut, bei neuen Architekturen musst du aber öfter warten. Auf dem Mac gibt es mit MLX eine eigene Laufzeitumgebung; Ollama bietet für einige Modelle, etwa Qwen3.8-27B, schon MLX-Varianten an.
- Stromverbrauch. Eine RTX 5090 zieht bis zu 575 Watt, die PRO 6000 600 Watt. Der GB10-Chip im DGX Spark ist mit 140 Watt spezifiziert, ein Mac Studio mit maximal 480 Watt. Für einen Rechner, der rund um die Uhr läuft, ist das ein Kostenfaktor.
- Laufzeitumgebung. Wie du Ollama, llama.cpp oder vLLM so einrichtest, dass ein Coding-Agent zuverlässig damit arbeitet, beschreibt Lokale Modelle einbinden. Eine ChatGPT-ähnliche Oberfläche für das ganze Team baust du mit Open WebUI und Ollama.
Wann du nicht kaufen solltest
Wenn du ein lokales Modell nur ausprobieren willst, kauf nichts. Jeder Mac mit Apple Silicon und jede vorhandene Grafikkarte ab 8 GB reicht für Gemma 4 12B oder Qwen3.5 9B, und damit merkst du schnell, ob dir lokal genügt. Wer vor allem die beste Qualität will und keine Datenschutzgründe hat, fährt mit einer Cloud-API bei den aktuellen Hardwarepreisen günstiger – für 7.800 Euro, den Preis einer RTX 5090, bekommst du sehr viele Millionen Token. Wie du Cloud-Kosten im Griff behältst, steht in LLM-Kosten optimieren. Lokal lohnt sich, wenn Daten das Haus nicht verlassen dürfen, wenn du viele Anfragen hast oder wenn Unabhängigkeit von Anbietern für dich zählt.
Häufige Fragen
Welche Grafikkarte brauche ich für lokale LLMs? Für das derzeit beste lokale Modell, Qwen3.8-27B, brauchst du mindestens 24 GB Grafikspeicher, besser 32 GB für langen Kontext. Die günstigste Karte mit 24 GB ist die Intel Arc Pro B60 ab 889 Euro, mit 32 GB die AMD Radeon AI PRO R9700 ab rund 2.000 Euro. Mit 16 GB laufen kleinere Modelle wie Gemma 4 12B gut.
Was ist das beste lokale LLM im November 2026? Für Rechner mit einer Grafikkarte ist es Qwen3.8-27B: Im Intelligence Index von Artificial Analysis liegt es auf Rang 7 der offenen Modelle, und alle Modelle davor brauchen Server-Hardware. Mit 64 bis 128 GB Speicher ist Qwen3.8-Flash-Next die stärkere, aber weniger stabile Alternative.
Reicht ein Mac für lokale LLMs? Ja, wenn er genug Speicher hat. Ab 48 GB läuft Qwen3.8-27B mit Kontext, ab 128 GB auch große MoE-Modelle. Die Ausgabe ist schnell, die Verarbeitung langer Prompts langsamer als auf NVIDIA-Karten; die M5-Generation hat diesen Abstand aber deutlich verkleinert.
DGX Spark oder Strix Halo – was ist besser? Beide haben 128 GB und eine ähnliche Bandbreite, deshalb ist die Ausgabe ähnlich schnell. Der DGX Spark verarbeitet lange Prompts etwa doppelt so schnell und läuft mit der kompletten CUDA-Software. Strix Halo kostet mit rund 3.900 Euro aber deutlich weniger als die GB10-Geräte ab 5.700 Euro.
Wie viele Token pro Sekunde sind genug? Für einen Chat reichen etwa 20 Token pro Sekunde, das ist schneller, als du liest. Für Coding-Agenten, die viel Text erzeugen und in mehreren Schritten arbeiten, sind 40 und mehr angenehm. Wichtiger als die Ausgabegeschwindigkeit ist bei Agenten oft die Zeit, bis die Verarbeitung des langen Prompts abgeschlossen ist.
Lohnt sich eine gebrauchte RTX 3090 noch? Zu den aktuellen Preisen kaum. Generalüberholte 3090 kosten in Deutschland rund 2.000 bis 2.500 Euro, also mehr als eine neue Radeon AI PRO R9700 mit 32 GB. Die 3090 ist unter CUDA schneller, die R9700 hat mehr Speicher und Garantie.
Werden Grafikkarten bald wieder günstiger? Danach sieht es nicht aus. Marktforscher erwarten für Ende 2026 weiter steigende Speicherpreise, weil die Kapazität in KI-Rechenzentren fließt. Angekündigte neue Consumer-Karten mit mehr Speicher gibt es von NVIDIA derzeit nicht.
Zusammenfassung und praktische Tipps
- Speicher vor Rechenleistung. Modell und Kontext müssen komplett in den Speicher passen, sonst bricht die Geschwindigkeit um eine Größenordnung ein.
- Bandbreite bestimmt das Tempo. Bandbreite geteilt durch Modellgröße ergibt die Obergrenze der Ausgabe; real erreichst du 60 bis 85 Prozent.
- Qwen3.8-27B ist der Maßstab. Bestes lokal betreibbares Modell, Apache 2.0, ab 24 GB Grafikspeicher.
- MoE macht geteilten Speicher brauchbar. Auf DGX Spark und Strix Halo liefern MoE-Modelle 50 bis 60 Token pro Sekunde, dichte Modelle 12.
- Prefill nicht vergessen. Für Coding-Agenten und RAG sind NVIDIA-Karten beim Verarbeiten langer Prompts um ein Vielfaches schneller als Macs und Strix Halo.
- Preise sind Momentaufnahmen. Die RTX 5090 kostet fast das Vierfache ihrer Preisempfehlung; prüf den Preis am Kauftag.
- Günstigster Einstieg mit 24 GB: Intel Arc Pro B60. Mit 32 GB: AMD Radeon AI PRO R9700. Mit 128 GB: Strix Halo.
- Für Teams vLLM statt Ollama. Nur mit Batching skaliert der Durchsatz mit der Zahl der Nutzer.
- Erst probieren, dann kaufen. Vorhandene Hardware reicht für kleine Modelle und zeigt dir, ob lokal für dich genügt.
Mein Rat: Wenn du heute kaufen musst, kauf für das Modell, nicht für die Zukunft. Für Qwen3.8-27B und einen Coding-Agenten für dich allein ist eine Karte mit 24 bis 32 GB der wirtschaftlichste Weg – zum aktuellen Preis eher eine Radeon AI PRO R9700 als eine RTX 5090. Wenn du größere Modelle willst und Geduld beim Prompt hast, ist ein Strix-Halo-Rechner mit 128 GB das beste Preis-Leistungs-Verhältnis; wenn du CUDA brauchst, der DGX Spark. Den Mac Studio würde ich nehmen, wenn Lautstärke und Stromverbrauch zählen oder wenn du mit 256 oder 512 GB Modelle betreiben willst, für die es sonst keine Desktop-Lösung gibt. Und wenn du keinen klaren Grund für lokal hast: Bei diesen Hardwarepreisen ist die Cloud derzeit die günstigere Wahl.
Ressourcen
- c't 3003: Lokale KI – Das läuft auf deinem Rechner – Hardwarevergleich mit Qwen3.8-27B, Preise und Empfehlungen vom 6. November 2026
- iX: Große LLMs auf Desktop-Hardware im Test – Qwen3.8-Flash-Next mit Strata auf RTX 5090 und Mac (heise+)
- Hardware Corner: Qwen3.8 27B Hardware-Tests – Messreihe über sechs Plattformen bis 128k Kontext
- Artificial Analysis: Open-Weights-Modelle – aktuelle Rangliste nach Intelligence Index v5
- llama.cpp: Benchmarks mit gpt-oss – Community-Messwerte auf vielen GPUs
- llama.cpp: DGX Spark und Strix Halo – Vergleich der 128-GB-Systeme mit Kontexttiefe
- llama.cpp: Apple-Silicon-Referenztest – Prefill und Generierung aller M-Chips bis M5
- LMSYS: NVIDIA DGX Spark im Test – Messwerte mit SGLang und Ollama, inklusive Batching
- Jeff Geerling: Benchmarks Mac Studio M3 Ultra – große MoE-Modelle bis DeepSeek-R1 auf 512 GB
- 3DCenter: Speicherkrise-Preisindex Oktober 2026 – Preisentwicklung von Grafikkarten und DDR5
- heise Preisvergleich – aktuelle Straßenpreise für alle genannten Geräte
- Qwen3.8-27B (Hugging Face) – Modellkarte des Referenzmodells
- Qwen3.8-Flash-Next (Hugging Face) – Modellkarte, Architektur und Lizenz
- Lokale LLMs auf der RTX 4090 – eigene Messwerte, Ollama gegen vLLM, dense gegen MoE
- Welches Ollama-Modell? – Modellauswahl für vorhandene Hardware
- Qwen3.8-27B gegen die Cloud – was das Referenzmodell beim Coding leistet
- Quantisierung von LLMs erklärt – warum 4 Bit meist reicht
- Ollama auf Deutsch – welche lokalen Modelle gutes Deutsch schreiben
- Lokale Modelle einbinden – Laufzeitumgebung für Editor und Agent einrichten