
Kolibri 1 von Aleph Alpha: Was taugt das deutsche Open-Weight-Modell?
Kolibri 1 von Aleph Alpha: Was taugt das deutsche Open-Weight-Modell?
Artikel-Übersicht
Am 3. Oktober 2026, pünktlich zum Tag der Deutschen Einheit, hat Aleph Alpha Kolibri 1 veröffentlicht: ein offenes Sprachmodell, von Grund auf in Deutschland entwickelt, unter Apache 2.0 und mit einem erklärten Schwerpunkt auf der deutschen Sprache. Die kurze Antwort auf die Titelfrage: Kolibri 1 ist ein solides Modell mit echten Stärken bei Mathematik, Anweisungstreue und deutschsprachigen Aufgaben – aber kein Spitzenreiter, und für den Betrieb auf eigener Hardware derzeit deutlich unbequemer als die Konkurrenz von Qwen.
Dieser Artikel schaut genauer hin. Er erklärt die Architektur und das Training, ordnet die Benchmarks aus der Modellkarte ein, benennt die Schwächen, die Aleph Alpha in seinem 189-seitigen Tech Report selbst einräumt, und sammelt die ersten Erfahrungen aus der Community. Der Praxisteil zeigt, welche Hardware Kolibri 1 braucht, wie man es mit vLLM betreibt und was mit GGUF, MLX und Ollama heute möglich ist. Grundlage sind die Modellkarte auf Hugging Face, der Tech Report, der Blogpost von Aleph Alpha, die GitHub-Repositories der Inferenz-Werkzeuge und die Diskussionen auf Hugging Face, Stand 10. Oktober 2026.
Wenn du lokale Modelle schon betreibst, sind zwei frühere Artikel ein guter Vergleichsmaßstab: Qwen3.8-27B gegen die Cloud zeigt, was ein aktuelles dichtes Modell lokal leistet, und Quantisierung von LLMs erklärt die Grundlagen zu GGUF und Co., die du für den Praxisteil brauchst.
Kolibri 1 auf einen Blick
Kolibri 1 ist ein Mixture-of-Experts-Modell mit 78,1 Milliarden Parametern, von denen pro Token nur 3,46 Milliarden aktiv sind – es braucht also den Speicher eines großen Modells, rechnet aber wie ein kleines.
| Eigenschaft | Wert |
|---|---|
| Veröffentlichung | 3. Oktober 2026 |
| Lizenz | Apache 2.0 (Gewichte) |
| Parameter | 78,1 Mrd. gesamt, 3,46 Mrd. aktiv |
| Architektur | Mixture of Experts: 384 Experten je Schicht, davon 6 aktiv, plus 1 geteilter Experte |
| Kontext | 262.144 Token nativ, 1.048.576 per Extrapolation |
| Sprachen | Deutsch und Englisch, nur Text |
| Tokenizer | eigener „UniBPE", 128.000 Token |
| Wissensstand | 18. Juni 2026 |
| Varianten | Aleph-Alpha/Kolibri-1 (FP8, ca. 79 GB), Aleph-Alpha/Kolibri-1-BF16 (ca. 156 GB) |
| Typ | Reasoning-Modell mit einstellbarer Denktiefe |
Wichtig für die Einordnung: Es gibt genau ein Modell in zwei Genauigkeiten. Ein Basismodell zum eigenen Finetuning wurde nicht veröffentlicht, kleinere Größen auch nicht. Die gelegentlich erwähnte „30,6-Milliarden-Variante" ist Kolibri Origin, ein internes Vorgängermodell, mit dem Aleph Alpha seine Trainingspipeline erprobt hat. Es ist nicht öffentlich.
Die Architektur: viele kleine Experten
Kolibri 1 setzt auf sehr viele, sehr kleine Experten: 384 pro Schicht, von denen ein Router für jedes Token sechs auswählt. Dazu kommt ein geteilter Experte, der immer mitrechnet. Das Prinzip:
                    Token
                      │
                ┌─────▼─────┐
                │ Attention │   4 Sliding-Window-Schichten (512 Token, RoPE)
                └─────┬─────┘   : 1 Full-Attention-Schicht (ohne Positionskodierung)
                      │
              ┌───────▼────────┐
              │     Router     │  wählt 6 von 384 Experten (Sigmoid-Gating)
              └─┬──┬──┬──┬──┬──┘
                ▼  ▼  ▼  ▼  ▼  ▼
               E17 E42 E99 …  E301      + 1 geteilter Experte (immer aktiv)
                └──┴──┴──┬──┴──┘
                         ▼
                   gewichtete Summe  ──►  nächste der 50 Schichten
Daraus folgt die wichtigste praktische Eigenschaft von MoE-Modellen: Rechenaufwand und Speicherbedarf entkoppeln sich. Pro Token rechnet Kolibri ungefähr so viel wie ein 3,5-Milliarden-Modell, deshalb ist es schnell. Im Speicher liegen müssen aber alle 78 Milliarden Parameter, weil jedes Token andere Experten wählen kann. Das macht das Modell auf einer einzelnen Consumer-GPU schwer zu betreiben – dazu gleich mehr.
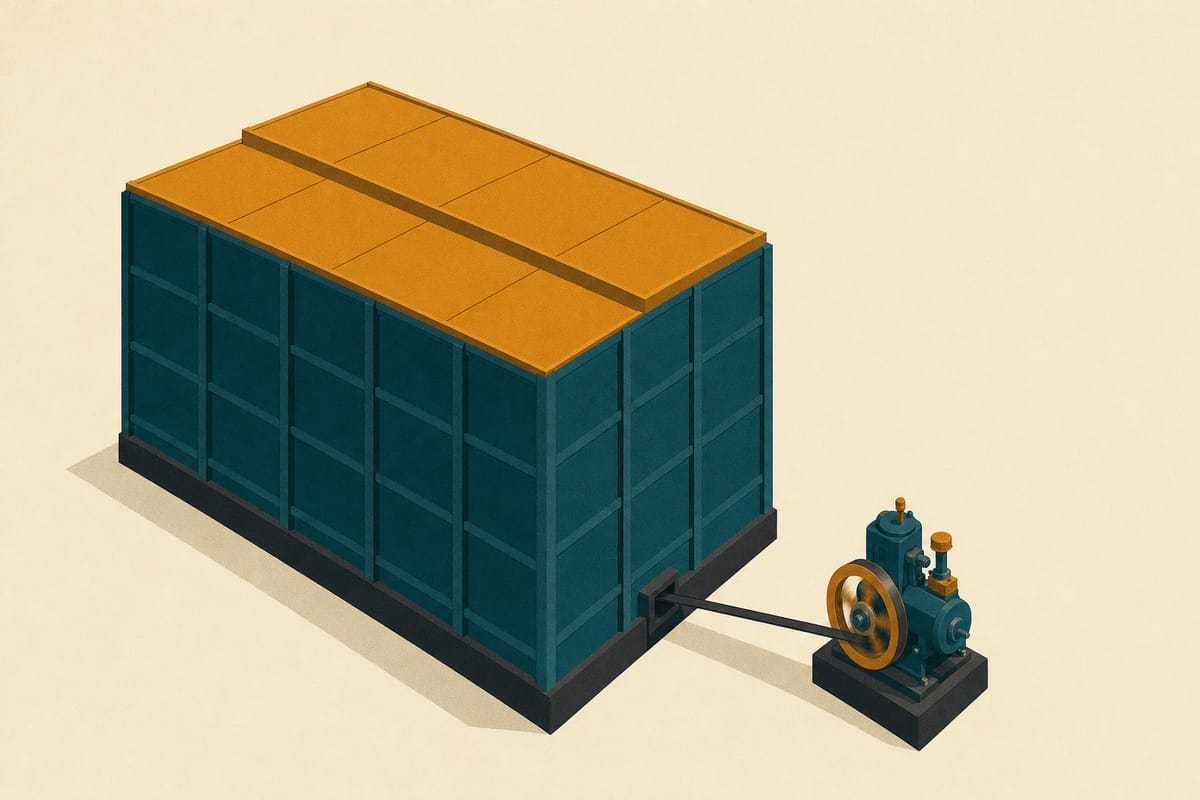
Illustration eines riesigen, dunkel-türkisen Lagerblocks mit orangefarbenem Dach, der über einen einzelnen Riemen mit einem winzigen Motor mit Schwungrad verbunden ist
Das Verhältnis bei Kolibri 1: Der Speicher muss alle 78 Milliarden Parameter fassen, gerechnet wird pro Token nur mit 3,5 Milliarden. Ein großes Lager mit einem kleinen Motor.
Weitere Details aus der Konfiguration:
- 50 Schichten, Hidden Size 2.560, 48 Attention-Heads bei 4 Key-Value-Heads (Grouped Query Attention). Das hält den KV-Cache bei langen Kontexten klein.
- Attention im Verhältnis 4:1: Vier Schichten sehen nur ein gleitendes Fenster von 512 Token, jede fünfte sieht den ganzen Kontext. Nur die Fenster-Schichten nutzen RoPE, die globalen Schichten kommen ohne Positionskodierung aus. Das ist der Trick, mit dem das Modell über die trainierte Länge hinaus extrapolieren soll.
- FP8-Gewichte in Blöcken von 128 × 128, Embeddings, Ausgabeschicht, Normalisierungen und Router bleiben in BF16.
Wie Attention, Köpfe und Positionskodierung grundsätzlich funktionieren, erkläre ich in Transformer-Architektur: wie moderne Sprachmodelle aufgebaut sind.
Ein eigener Tokenizer für Deutsch
Kolibri nutzt einen selbst entwickelten Tokenizer namens UniBPE: klassisches Byte Pair Encoding, bei dem die Verschmelzungen über ein Unigram-Ziel ausgewählt werden. Laut Modellkarte erreicht er 4,7 Bytes pro Token auf Deutsch und 4,2 auf Englisch. Das ist relevant, weil deutsche Komposita bei englisch optimierten Tokenizern oft in viele kleine Stücke zerfallen – was Kontext kostet und die Generierung verlangsamt. Ein tokenizerfreies Verfahren, wie Aleph Alpha es früher erforscht hat, steckt in Kolibri nicht.
Training: 24 Billionen Token, ein Fünftel Deutsch
Kolibri 1 wurde von Grund auf trainiert, ohne ein fremdes Basismodell – das ist das zentrale Argument für die Souveränität, mit dem Aleph Alpha wirbt.
| Phase | Token | Sequenzlänge |
|---|---|---|
| Pre-Training | 20 Billionen | 16k |
| Mid-Training | 3,44 Billionen | 65k |
| Langkontext | 201 Milliarden | 262k |
Der deutsche Anteil am Pre-Training liegt laut Tech Report und Blog bei 21,3 Prozent, rund 4,3 Billionen Token. Die Modellkarte nennt 23,9 Prozent Deutsch neben 62,5 Prozent Englisch und 13,6 Prozent Code; vermutlich sind dort deutsche Web- und Instruktionsdaten zusammengezählt, erklärt wird der Unterschied nicht. Etwa 24 Prozent der Pre-Training-Daten sind synthetisch, über zwei Billionen deutsche Token hat Aleph Alpha nach eigenen Angaben selbst kuratiert oder erzeugt.
Trainiert wurde auf 768 NVIDIA-B200-GPUs in Deutschland und Finnland. Das Pre-Training dauerte 21 Tage und rund 392.000 GPU-Stunden; insgesamt nennt der Tech Report 6,4 × 10²³ FLOPs und etwa 950 MWh Energie. Methodisch fallen der Optimizer Muon für die Gewichtsmatrizen, ein eigenes Verfahren für die gleichmäßige Auslastung der Experten und ein Reinforcement-Learning-Schritt mit über 1,2 Millionen Aufgaben auf – letzterer quantisierungsbewusst, damit das Modell in FP8 nicht leidet. Ein eigener Trainingsteil soll dem Modell beibringen, sich bei Unwissen zu enthalten, statt zu raten.
Bemerkenswert offen ist der Tech Report bei zwei Punkten:
- HumanEval ist kontaminiert. Der Pre-Training-Datenpool wurde nicht bereinigt. Am Ende des Mid-Trainings waren 48 Prozent der englischen und 47 Prozent der deutschen HumanEval-Lösungen wörtliche Wiedergaben der Referenzlösungen. Aleph Alpha schreibt selbst, die HumanEval-Werte seien „inflated".
- Politischer Bias aus fremden Modellen. Die Modellkarte räumt ein, dass Trainingsdaten von chinesischen Sprachmodellen erzeugtes Material mit politischer Färbung enthalten, und gibt an, dagegen gezielt gegengesteuert zu haben.
Die Benchmarks: stark in Mathe und Anweisungen, schwach bei Wissen und Agenten
In den Herstellerbenchmarks liegt Kolibri 1 im Gesamtwert knapp vor den gleich großen MoE-Modellen von Qwen – fällt aber bei Agenten-Aufgaben, Werkzeugaufrufen und Faktenwissen zurück. Alle Zahlen stammen von Aleph Alpha selbst, gemessen mit eigenem Evaluations-Framework und höchster Denktiefe.
| Benchmark | Kolibri 1 | Qwen3.6 35B-A3B | Qwen3.5 35B-A3B | GPT-OSS 120B | Nemotron 3 Super | Qwen3.8 27B (dicht) |
|---|---|---|---|---|---|---|
| Gesamt Englisch | 75,5 | 71,4 | 74,7 | 72,3 | 73,0 | 80,2 |
| Gesamt Deutsch | 70,8 | 67,3 | 69,8 | 70,2 | 67,9 | 79,9 |
| GPQA Diamond (EN) | 84,3 | 83,4 | 83,8 | 76,4 | 78,0 | 89,2 |
| AIME 2026 (EN) | 96,0 | 91,0 | 92,1 | 90,8 | 90,4 | 97,7 |
| LiveCodeBench v6 | 85,9 | 82,5 | 77,8 | 87,5 | 82,0 | 93,8 |
| SWE-Bench Verified | 66,4 | 73,8 | 71,6 | – | 60,2 | 72,6 |
| TerminalBench 2.1 | 27,7 | – | 39,7 | 29,2 | 39,7 | 76,8 |
| BFCL v4 (Werkzeugaufrufe) | 61,4 | 67,2 | 70,5 | 57,3 | 61,0 | 73,2 |
| BFCL v3 Multi-Turn | 39,8 | 53,5 | 54,0 | 45,6 | 44,6 | 42,5 |
| IFBench (Anweisungstreue) | 78,1 | 66,1 | 72,7 | 71,1 | 73,7 | 81,9 |
| AA-Omniscience (Wissen) | −32,8 | −12,5 | −46,2 | −35,2 | −36,5 | −5,8 |
| LongBench Pro | 64,5 | 70,8 | 70,3 | – | 62,9 | 76,9 |
Was man daraus lesen kann:
- Mathematik und Wissenschaft sind die Stärke. Bei AIME und GPQA liegt Kolibri vor allen MoE-Modellen ähnlicher Größe.
- Anweisungstreue ist bemerkenswert gut. IFBench 78,1 gegenüber 66,1 bei Qwen3.6 – für Anwendungen mit strengen Formatvorgaben ein echter Punkt.
- Agenten und Werkzeuge sind die Schwäche. SWE-Bench, TerminalBench und vor allem BFCL Multi-Turn liegen klar unter Qwen. Wer Kolibri als Coding-Agent einsetzen will, ist mit Qwen besser bedient.
- Faktenwissen ohne Nachschlagen ist schwach. Der negative Omniscience-Wert bedeutet, dass das Modell häufiger falsch liegt als richtig, wenn es ohne Quellen antworten soll. Für Anwendungen mit RAG ist das weniger kritisch – dort schneidet es in Aleph Alphas eigenem agentischen RAG-Test „Honeypot" mit 80,8 gut ab.
- Der Deutsch-Vorsprung ist kleiner als erwartet. Im deutschen Gesamtwert liegt Kolibri 1,0 Punkte vor Qwen3.5 und 0,6 vor GPT-OSS 120B. Ein Modell, das ein Fünftel seiner Trainingsdaten auf Deutsch gesehen hat, setzt sich damit nicht deutlich ab.
- Das dichte Qwen3.8 27B schlägt alle. Aleph Alpha führt es in der Tabelle ausgegraut mit, aber nicht in der Wertung. In fast jeder Zeile liegt es vorn, braucht dafür aber auch pro Token achtmal so viel Rechenleistung.
Ein Ausreißer verdient Vorsicht: Bei Tau3 Banking erreicht Kolibri 38,1, alle anderen MoE-Modelle liegen bei 10 bis 16. So ein Abstand gehört unabhängig nachgemessen, bevor man ihn glaubt.
Langer Kontext: 1 Million Token ist Extrapolation
Viele Meldungen sprechen von „1 Million Token Kontext". Trainiert ist das Modell bis 262.144 Token, alles darüber ist Extrapolation – und Aleph Alpha empfiehlt selbst, unter 262k zu bleiben. Die RULER-Werte des (unveröffentlichten) Basismodells zeigen das Muster: 86,9 bei 4k, 67,9 bei 128k, 63,2 bei 1M. Qwen3.5 liegt bei kurzen und mittleren Längen deutlich vorn (96,3 bei 4k, 89,9 bei 128k) und fällt erst bei 1M zurück. Warum lange Kontexte grundsätzlich an Qualität verlieren, beschreibe ich in Das Context Window verstehen.
Was die Community bisher sagt
Unabhängige Evaluationen gibt es eine Woche nach dem Release kaum. Artificial Analysis hat das Modell noch nicht gelistet. Was es gibt:
- Trending Topics sieht Kolibri „no match for the open-weight leaders" und kritisiert, dass die Vergleichsmodelle rund ein halbes Jahr alt sind.
- DataCamp empfiehlt bei ähnlicher Größe weiterhin Qwen3.6 35B-A3B und hebt dieselben Schwächen hervor: HumanEval-Kontamination, schwaches Faktenwissen, Multi-Turn-Werkzeugaufrufe.
- Auf Hugging Face berichten Nutzer von rund 48 Token/s auf einem DGX Spark mit vLLM, von 86 von 100 Punkten im Community-Test „tool-eval-bench" – und von einem offenen Fehler: Mit Coding-Harnesses wie Codex oder Claude Code liefert der Tool-Call-Parser ungültiges JSON.
Kolibri 1 selbst betreiben
Offiziell unterstützt ist nur vLLM mit einem Plugin von Aleph Alpha, und das nur auf NVIDIA-GPUs mit mindestens 80 GB. Für Heimanwender führt der Weg derzeit über Community-Quantisierungen und gepatchte Software.
Hardware
| Variante | Mindestens laut Modellkarte |
|---|---|
FP8 (Kolibri-1) |
2× A100 80 GB, 2× H100, 1× H200, 1× B200 oder 1× B300 |
BF16 (Kolibri-1-BF16) |
4× A100/H100, 2× H200 oder 1× B200/B300 |
Für den Rechenzentrumsbetrieb ist das moderat. Für eine Workstation mit einer RTX 4090 oder 5090 reicht es nicht – da kommen nur stark quantisierte Fassungen in Frage, bei denen die Experten im Arbeitsspeicher liegen.
Offizieller Weg: vLLM
Aleph Alpha liefert ein Plugin namens aleph-alpha-inference, festgelegt auf vLLM 0.29 und CUDA. Alternativ gibt es ein fertiges Container-Image.
pip install 'aleph-alpha-inference>=1'

vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Der Server spricht die OpenAI-kompatible API. Die Denktiefe steuerst du über chat_template_kwargs, die Sampling-Empfehlung des Herstellers ist ungewöhnlich offen:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="egal")
antwort = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{"role": "user", "content": "Erkläre den Unterschied zwischen GmbH und UG in drei Sätzen."}],
    temperature=1.0,
    top_p=0.97,
    extra_body={"top_k": 128,
                "chat_template_kwargs": {"reasoning_effort": "medium"}},   # none | low | medium | high
)
print(antwort.choices[0].message.content)
Wer über 262k Token hinaus will, muss die Länge beim Start explizit überschreiben (--max-model-len 1048576 --hf-overrides '{"max_position_embeddings":1048576}') – mit den oben beschriebenen Qualitätseinbußen.
Native Unterstützung in vLLM und in Hugging Face transformers ist in Arbeit, die Pull Requests waren am 10. Oktober aber noch offen. SGLang unterstützt das Modell bisher nicht.
Community-Weg: GGUF, MLX und Ollama
llama.cpp unterstützt die Architektur offiziell noch nicht. Es gibt einen Feature-Request, aber keinen Pull Request. Trotzdem existieren bereits GGUF-Dateien – sie laufen nur mit einem gepatchten llama.cpp oder einem Fork. Das meistgeladene Repository ist Hob-forge/Kolibri-1-GGUF:
| Quantisierung | Dateigröße |
|---|---|
| Q2_K | 28,6 GB |
| Q3_K_M | 37,5 GB |
| Q4_K_M | 47,5 GB |
| Q5_K_M | 55,6 GB |
| Q6_K | 64,2 GB |
| Q8_0 | 83,1 GB |
Der Ersteller nennt für Q4_K_M auf einem Ryzen 7800X3D mit 128 GB RAM rund 12 Token/s rein auf der CPU und 18 Token/s, wenn eine RTX 5070 mit 12 GB die gemeinsamen Teile übernimmt und die Experten im Arbeitsspeicher bleiben. Genau dafür sind MoE-Modelle mit wenig aktiven Parametern gut geeignet: Der Arbeitsspeicher trägt die Masse, die GPU beschleunigt den Rest.
Für Apple Silicon gibt es MLX-Fassungen von 2 bis 8 Bit, etwa velaia/Kolibri-1-MLX-4bit. Mit 4 Bit braucht das Modell grob 40 bis 45 GB, ein Mac mit 64 GB gemeinsamem Speicher ist damit die realistische Untergrenze.
Ollama hat keinen offiziellen Eintrag. Es gibt einen Community-Upload (robit/kolibri-1:q4_k_m, 65 GB); der GGUF-Ersteller schreibt aber, dass Ollama und LM Studio die Architektur in der Standardfassung noch nicht laden können. Ob der Upload ohne Anpassungen läuft, ist unklar – ich würde damit warten, bis llama.cpp die Architektur offiziell kann. Wie du Ollama allgemein einrichtest und welche Modelle zu welcher Hardware passen, steht in Welches Ollama-Modell?.
Zum Vergleich der Speicherbedarf der nächsten Konkurrenten:
| Modell | Parameter gesamt / aktiv | Lizenz | llama.cpp / Ollama |
|---|---|---|---|
| Kolibri 1 | 78,1 / 3,46 Mrd. | Apache 2.0 | nur gepatcht / inoffiziell |
| Qwen3.6 35B-A3B | 36,0 / ca. 3 Mrd. | Apache 2.0 | ja |
| GLM-4.7-Flash | 31,2 / ca. 3 Mrd. | MIT | ja |
| Gemma 4 26B-A4B | 25,8 / 4 Mrd. | Apache 2.0 | ja |
| GPT-OSS 120B | 116,8 / ca. 5,1 Mrd. | Apache 2.0 | ja |
| Mistral Small 4 | 119,4 / 6 Mrd. | Apache 2.0 | – |
Kolibri braucht bei ähnlicher Rechenlast etwa doppelt so viel Speicher wie Qwen3.6 35B-A3B – und hat das schwächere Ökosystem. Das ist der praktische Kern des Vergleichs.
Souveränität: das eigentliche Verkaufsargument
Aleph Alpha positioniert Kolibri nicht als Benchmark-Sieger, sondern als souveränes Modell für regulierte Bereiche: öffentliche Verwaltung, Industrie, Luft- und Raumfahrt. Die Argumente laut Blog und Modellkarte:
- komplett in Deutschland entwickelt, trainiert in Deutschland und Finnland „unter europäischem und deutschem Recht",
- keine Abhängigkeit von einem fremden Basismodell,
- entwickelt mit Blick auf AI Act, den Verhaltenskodex für KI-Modelle mit allgemeinem Verwendungszweck (den Aleph Alpha unterzeichnet hat) und DSGVO,
- eigene Testsuiten für deutsche Verwaltung, Luftfahrt, Automobilzulieferer, Halbleiter und Antriebstechnik.
Für Behörden und Unternehmen, die ein Modell vollständig im eigenen Haus betreiben müssen und eine nachvollziehbare Herkunft brauchen, ist das ein echtes Argument. Die Apache-2.0-Lizenz erlaubt kommerzielle Nutzung ohne Einschränkungen. Offen im Sinne von Open Source ist Kolibri aber nicht: Veröffentlicht sind die Gewichte, nicht der Trainingscode und nicht die Trainingsdaten. Die Modellkarte grenzt die Lizenz sogar ausdrücklich ein: Die Rechte aus Apache 2.0 gelten nur für die Gewichte und Konfigurationsdateien im Repository und erstrecken sich „especially not“ auf Code, Modellarchitektur, Parametereinstellungen oder Trainingsmethoden. Für die Nutzung des Modells spielt das keine Rolle, für jemanden, der die Architektur nachbauen will, schon.
Einen Haken hat die Souveränitätserzählung: Laut Berichten von SiliconANGLE und Trending Topics haben Aleph Alpha und das kanadische Unternehmen Cohere am 16. September 2026 eine verbindliche Fusionsvereinbarung unterzeichnet; das vereinte Unternehmen soll unter der Marke Cohere auftreten, mit Sitzen in Berlin und Toronto. Abgeschlossen ist die Fusion nach diesen Berichten noch nicht. Für die veröffentlichten Gewichte ändert das nichts – sie stehen unter Apache 2.0 und bleiben verfügbar. Für die Frage, wer künftige Versionen entwickelt und unter welcher Kontrolle, sehr wohl.
Eine gehostete API mit öffentlichen Preisen gibt es nicht; Unternehmenszugang läuft über den Vertrieb.
Für wen lohnt sich Kolibri 1?
| Einsatz | Empfehlung |
|---|---|
| Behörde oder Unternehmen mit Souveränitätsanforderung und eigener GPU-Infrastruktur | Kolibri prüfen – Herkunft und Lizenz sind die Stärke |
| Deutschsprachige Texte, Zusammenfassungen, strikte Formatvorgaben | Kolibri testen – Anweisungstreue und Deutsch sind gut |
| Mathematik, naturwissenschaftliches Reasoning | Kolibri konkurrenzfähig |
| Coding-Agent, viele Werkzeugaufrufe | Qwen3.6 oder Qwen3.8 |
| Faktenfragen ohne Quellen | beide schwach – RAG verwenden |
| Lokaler Betrieb auf Workstation oder Mac | Qwen – halber Speicher, reifes Ökosystem |
Häufige Fragen
Ist Kolibri 1 kostenlos nutzbar? Ja. Die Gewichte stehen unter Apache 2.0 auf Hugging Face und dürfen auch kommerziell genutzt werden. Kosten entstehen nur für die Hardware oder Cloud-GPUs, auf denen du das Modell betreibst.
Läuft Kolibri 1 mit Ollama? Offiziell nicht. Es gibt einen Community-Upload, aber llama.cpp – die Grundlage von Ollama – unterstützt die Architektur noch nicht offiziell. Die vorhandenen GGUF-Dateien brauchen ein gepatchtes llama.cpp.
Welche Hardware brauche ich für Kolibri 1? Für die offizielle FP8-Fassung mindestens zwei GPUs mit 80 GB oder eine H200 beziehungsweise B200. Quantisiert auf 4 Bit läuft es mit rund 48 GB auf einem Rechner mit viel Arbeitsspeicher oder einem Mac mit 64 GB, dann aber deutlich langsamer.
Ist Kolibri 1 besser als Qwen? Bei Mathematik, Anweisungstreue und im Gesamtwert der Herstellerbenchmarks liegt es knapp vor Qwen3.5 und Qwen3.6 in ähnlicher Größe. Bei Agenten-Aufgaben, Werkzeugaufrufen und langen Kontexten liegt Qwen vorn, und das dichte Qwen3.8 27B ist fast überall stärker.
Hat Kolibri 1 wirklich 1 Million Token Kontext? Trainiert ist es bis 262.144 Token. Eine Million ist per Extrapolation möglich, aber mit messbarem Qualitätsverlust. Aleph Alpha empfiehlt selbst, unter 262k zu bleiben.
Ist Kolibri 1 Open Source? Es ist Open Weight: Die Gewichte sind frei verfügbar. Trainingscode und Trainingsdaten sind nicht veröffentlicht. Der 189-seitige Tech Report beschreibt das Verfahren aber ungewöhnlich ausführlich.
Kann ich Kolibri 1 feintunen? Technisch ja, über die veröffentlichten Gewichte. Ein Basismodell ohne Instruktions- und Reasoning-Training gibt es aber nicht, und bei 78 Milliarden Parametern ist selbst LoRA-Finetuning ein Fall für Rechenzentrums-GPUs.
Zusammenfassung und praktische Tipps
- MoE mit viel Speicher, wenig Rechnung. 78 Mrd. Parameter im Speicher, 3,5 Mrd. pro Token – schnell, aber speicherhungrig.
- Deutsch ist gut, aber kein Alleinstellungsmerkmal. Der Vorsprung im deutschen Gesamtwert liegt bei rund einem Punkt.
- Stärken: Mathematik, naturwissenschaftliches Reasoning, Anweisungstreue, eigener Tokenizer mit guter Kompression für Deutsch.
- Schwächen: Werkzeugaufrufe über mehrere Runden, Coding-Agenten, Faktenwissen ohne Quellen, lange Kontexte.
- Benchmarks kritisch lesen. Alle Zahlen sind Herstellerwerte, HumanEval ist nach eigener Angabe kontaminiert, unabhängige Messungen fehlen noch.
- 1 Million Token ist Marketing. Bis 262k trainiert, darüber Extrapolation.
- Offiziell nur vLLM. Plugin
aleph-alpha-inference, NVIDIA, mindestens 80-GB-Klasse. - Lokal nur über Community-Fassungen. GGUF mit gepatchtem llama.cpp, MLX auf dem Mac, Ollama noch nicht offiziell.
- Souveränität als Hauptargument – mit Fragezeichen durch die angekündigte Fusion mit Cohere.
- Nachprüfen in vier Wochen. Native Unterstützung in vLLM, transformers und llama.cpp ist in Arbeit und ändert die Lage für den lokalen Betrieb.
Mein Rat: Wenn du einen konkreten Grund hast, ein in Deutschland trainiertes Modell zu nutzen – eine Behörde, ein Auftraggeber mit Souveränitätsklausel, eine Compliance-Abteilung, die die Herkunft eines chinesischen Modells nicht akzeptiert –, dann ist Kolibri 1 die erste ernsthafte Option in dieser Leistungsklasse, und du solltest es mit deinen eigenen Aufgaben testen. Wenn du einfach das beste offene Modell für deine Workstation suchst, gibt es diesen Grund nicht: Qwen3.6 35B-A3B oder das dichte Qwen3.8 27B sind stärker oder gleich stark, brauchen weniger Speicher und laufen heute schon überall. Dass ein deutsches Team ein Modell dieser Größe von Grund auf trainiert und so offen dokumentiert hat, ist trotzdem eine gute Nachricht – messen lassen muss es sich an den Zahlen, nicht an der Herkunft.
Ressourcen
- Kolibri 1 – Modellkarte (Hugging Face) – Architektur, Benchmarks, Hardware, Startbefehle
- Kolibri 1 BF16 (Hugging Face) – volle Genauigkeit
- Aleph Alpha: Kolibri has landed – offizielle Ankündigung und Positionierung
- Kolibri Tech Report (PDF) – Training, Daten, Kontamination, Evaluationen auf 189 Seiten
- aleph-alpha-inference (GitHub) – vLLM-Plugin und Container
- Hob-forge/Kolibri-1-GGUF (Hugging Face) – Community-GGUF mit Patch-Hinweisen und Messwerten
- DataCamp: Aleph Alpha Kolibri 1 – kritische Einordnung auf Deutsch
- Trending Topics: Kolibri – Einordnung im Vergleich zu aktuellen Spitzenmodellen
- SiliconANGLE: Cohere und Aleph Alpha fusionieren – Hintergrund zur Unternehmenslage
- Qwen3.8-27B gegen die Cloud – das stärkste dichte Vergleichsmodell im Praxistest
- Quantisierung von LLMs erklärt – GGUF, Q4_K_M und Co. verstehen
- Lokale Modelle einbinden: Ollama, llama.cpp und vLLM – vLLM-Server in Editor und Agent nutzen
- Transformer-Architektur – Attention, Köpfe und Positionskodierung
- Die führenden LLM-Anbieter 2026 im Vergleich – wo Aleph Alpha im Markt steht