
Lokale LLMs auf der RTX 4090: Ollama gegen vLLM, dense gegen MoE – eigene Messwerte
Artikel-Übersicht
Fast jede Hardware-Empfehlung für lokale Sprachmodelle endet bei derselben Aussage: „24 GB VRAM reichen für Modelle bis etwa 32 Milliarden Parameter.“ Das stimmt, sagt aber nichts darüber, wie schnell das Modell antwortet, wie viele Leute es gleichzeitig nutzen können und wie viel Kontext übrig bleibt. Genau diese Fragen entscheiden, ob ein eigener Ollama- oder LLM-Server im Alltag taugt. Dieser Artikel beantwortet sie mit Zahlen, die ich auf meinem eigenen Inferenz-Server gemessen habe: einer einzelnen RTX 4090 mit 24 GB unter Debian 12.
Der Artikel geht in dieser Reihenfolge vor: Messaufbau, die Physik hinter der Ausgabegeschwindigkeit, der überraschend große Einfluss des Grafiktreibers, Ollama gegen vLLM bei einem und bei vielen Nutzern, dense gegen Mixture-of-Experts, Kontextlänge und KV-Cache. Danach kommt der Teil für alle, die gerade Hardware kaufen wollen: RTX 3090, 4090 und 5090, NVIDIAs DGX Spark und der Mac Studio im direkten Vergleich, mit einer klaren Empfehlung je Einsatzzweck.
Was hier nicht steht, ist die Modellauswahl nach Speicherklasse. Welches Modell auf 8, 16, 24 oder 64 GB passt, beschreibt Welches Ollama-Modell? Auswahl nach Hardware und Zweck. Wie Quantisierung funktioniert, steht in Quantisierung von LLMs erklärt, die Installation in Ollama installieren. Wenn du nur eine Chat-Oberfläche für dich oder dein Team willst, ist die lokale ChatGPT-Alternative mit Open WebUI und Ollama der bessere Einstieg. Das dense-Modell aus den Messungen stelle ich in Qwen3.8-27B gegen die Cloud ausführlich vor.
Die kurze Antwort
Eine einzelne RTX 4090 reicht für einen lokalen LLM-Server, wenn du ein MoE-Modell nimmst und vLLM statt Ollama einsetzt, sobald mehr als eine Person gleichzeitig fragt. Mit einem MoE-Modell (Qwen3-Coder-30B-A3B) habe ich knapp 200 Token pro Sekunde für einen einzelnen Nutzer und über 900 Token pro Sekunde Gesamtdurchsatz bei acht parallelen Anfragen gemessen. Ein dense-Modell ähnlicher Größe schafft auf derselben Karte rund 54 Token pro Sekunde, und daran ändert kein Tuning etwas.
Drei Dinge zählen mehr als die Wahl der Grafikkarte:
- Der Treiber. Das Update von 535 auf 610 hat den Prefill unter Ollama um den Faktor 3,5 beschleunigt.
- Die Modellarchitektur. MoE statt dense brachte beim Decode Faktor 3,7.
- Die Laufzeitumgebung. Bei acht parallelen Anfragen lieferte vLLM mit dem dense-Modell das 4,3-Fache des Ollama-Durchsatzes.
Wer neu kauft: 24 GB sind die Untergrenze für einen ernsthaften Server, die Speicherbandbreite bestimmt die Geschwindigkeit, und der Speicher bestimmt, welche Modelle überhaupt laufen. Die Details folgen.
Der Messaufbau
Alle Zahlen in diesem Artikel stammen von einem Rechner, einem Benchmark-Skript und zwei Modellen, gemessen am 30. August 2026. Damit sind sie untereinander vergleichbar, aber nicht automatisch auf andere Systeme übertragbar.
| Komponente | Ausstattung |
|---|---|
| GPU | NVIDIA RTX 4090, 24 GB |
| Arbeitsspeicher | 125 GB |
| CPU | 32 Kerne |
| Betriebssystem | Debian 12 |
| Treiber | 535.183.01 (Debian), danach 610.57.04 (NVIDIA-CUDA-Repo) |
| Ollama | 0.33.2, GGUF Q4_K_M, Flash Attention und q8_0-KV-Cache |
| vLLM | 0.28.0 als Docker-Container, INT4 W4A16 (compressed-tensors) |
Die beiden Modelle:
- Qwen3.8-27B als dense-Modell mit 27,3 Milliarden Parametern. Unter vLLM als INT4-Checkpoint von RedHatAI (18,6 GB auf der Platte, rund 16,6 GB Gewichte ohne Vision-Teil), unter Ollama als GGUF Q4_K_M.
- Qwen3-Coder-30B-A3B als MoE-Modell mit 128 Experten, von denen pro Token 8 aktiv sind. AWQ-4-Bit von cyankiwi, 18,1 GB, nur unter vLLM gemessen.
Ollama und vLLM liefen nie gleichzeitig. Beide passen nicht zusammen in 24 GB, deshalb schließen sich die beiden systemd-Dienste per Conflicts= gegenseitig aus.
Das Benchmark-Skript spricht beide Server über dieselbe OpenAI-kompatible Schnittstelle an, mit Streaming und Temperatur 0. Es misst drei Dinge:
- Single-Stream-Decode: eine lange technische Erklärung als Ausgabe, gemessen wird die Zahl der erzeugten Token pro Sekunde nach dem ersten Token. Der erste Lauf gilt als Aufwärmrunde, gewertet wird der Median der übrigen.
- Prefill und TTFT: ein langer Prompt mit rund 2.000 bzw. 8.000 Wörtern, das sind 3.098 bzw. 11.498 Token beim Qwen3.8-Tokenizer. Gemessen wird die Zeit bis zum ersten Token (TTFT) und daraus die Prompt-Verarbeitung in Token pro Sekunde. Eine Zufalls-ID am Anfang verhindert, dass ein Prefix-Cache das Ergebnis schönt.
- Paralleldurchsatz: 1 bis 32 gleichzeitige Anfragen mit je 300 Ausgabetoken. Gemessen wird die Gesamtzahl erzeugter Token geteilt durch die Wandzeit.
Ein Vorbehalt gehört an den Anfang: Ollama und vLLM liefen mit unterschiedlichen Quantisierungsformaten. GGUF Q4_K_M und W4A16 sind beide 4-Bit-Verfahren, aber nicht identisch. Der Vergleich zeigt, was du mit dem jeweils üblichen Format bekommst, nicht einen Laborvergleich der Engines.
Warum die Ausgabegeschwindigkeit an der Speicherbandbreite hängt
Beim Decode muss die GPU für jedes einzelne Ausgabetoken alle aktiven Gewichte einmal aus dem Speicher lesen, deshalb setzt die Speicherbandbreite die Obergrenze, nicht die Rechenleistung. Die Rechnung ist simpel: Bandbreite geteilt durch die Datenmenge pro Token ergibt die maximale Zahl der Token pro Sekunde.
Für die RTX 4090 sieht das so aus: 384 Bit Speicherbus mal 21 Gbit/s pro Pin ergibt rund 1.008 GB/s. Ein dense-Modell mit 27 Milliarden Parametern liest in 4 Bit pro Token rund 16 GB. 1.008 geteilt durch 16 ergibt eine rechnerische Obergrenze von etwa 60 Token pro Sekunde. Gemessen habe ich unter vLLM 51 bis 54 Token pro Sekunde. Das ist praktisch das physikalische Limit der Karte für dieses Modell.
Zwei Prozesse muss man dabei auseinanderhalten:
Anfrage ──▶ PREFILL ──────────────▶ DECODE ──▶ Token, Token, Token …
            ganzer Prompt auf einmal   ein Token nach dem anderen
            rechenintensiv             bandbreitenlimitiert
            bestimmt die Wartezeit     bestimmt das Lesetempo
            bis zur ersten Antwort     der Ausgabe
Der Prefill verarbeitet den gesamten Prompt parallel und nutzt die Rechenwerke der GPU voll aus. Er bestimmt, wie lange du bei einem langen Dokument oder einer großen Codebasis auf das erste Wort wartest. Der Decode erzeugt danach Token für Token und hängt an der Bandbreite. Wer Hardware vergleicht, muss beide Werte getrennt betrachten. Ein System mit viel Speicher, aber geringer Bandbreite lädt große Modelle, gibt sie aber langsam aus.
Der unterschätzte Hebel: der Grafiktreiber
Das größte einzelne Plus auf meinem Server kam nicht von neuer Hardware oder einem anderen Modell, sondern vom Update des NVIDIA-Treibers von Version 535 auf 610. Debian 12 liefert den Treiber 535.183.01 aus. Mit dem 610er-Treiber aus NVIDIAs eigenem CUDA-Repository lief derselbe Ollama mit demselben Modell auf derselben Karte so:
| Metrik (Ollama, Qwen3.8-27B Q4_K_M) | Treiber 535 | Treiber 610 | Faktor |
|---|---|---|---|
| Prefill | 732 tok/s | 2.545 tok/s | 3,5x |
| Decode | 72 tok/s | 90 tok/s | +24 % |
Der Prefill-Gewinn ist der wichtigere. Bei einem Prompt von 11.498 Token heißt das: Rechnerisch wartest du statt knapp 16 Sekunden nur noch gut 4,5 Sekunden auf die erste Ausgabe. Für Coding-Agenten, die bei jedem Schritt große Teile einer Codebasis in den Kontext legen, ist das der Unterschied zwischen benutzbar und zäh.
Der Treiber ist bei neueren Modellen außerdem keine Frage des Tempos mehr, sondern der Lauffähigkeit. vLLM ab Version 0.26 ist auf CUDA 13 gebaut und braucht zwingend einen Treiber ab 580. CUDA 13 ist ein Major-Sprung, kein Kompatibilitätsschalter hilft darüber hinweg. Wer Qwen3.8-27B mit seiner hybriden Attention unter vLLM betreiben will, kommt am Treiber-Update nicht vorbei.
Zwei Stolpersteine beim Update unter Debian 12:
- Debians eigener CUDA-11.8-Stack (
nvidia-cuda-toolkit,libnpp*) blockiert die Installation per Paketkonflikt mitnvidia-libopencl1und muss vorher entfernt werden. - Das
nvidia-container-toolkitfür Docker überlebt das Update, sollte aber gleich mit aktualisiert werden. Bei mir ging es auf 1.20.0.
Mein Rat daraus: Bevor du über langsame Hardware klagst, prüf mit nvidia-smi die Treiberversion. Distributions-Treiber hinken oft deutlich hinterher.
Ollama gegen vLLM: ein Nutzer gegen viele
Für einen einzelnen Nutzer war Ollama in meiner Messung schneller, ab vier parallelen Anfragen ist vLLM um ein Vielfaches überlegen. Beide Messungen liefen mit Treiber 610 und dem dense-Modell Qwen3.8-27B.
| Metrik | Ollama 0.33.2 (Q4_K_M) | vLLM 0.28.0 (INT4 W4A16) |
|---|---|---|
| Decode, ein Stream | 89,8 tok/s | 53,9 tok/s |
| TTFT, kurzer Prompt | 0,229 s | 0,062 s |
| Prefill, 3.098 Token | 2.348 tok/s | 2.884 tok/s |
| Prefill, 11.498 Token | 2.545 tok/s | 2.824 tok/s |
| TTFT, 11.498 Token | 4,52 s | 4,07 s |
Unter Last sieht das Bild anders aus. Gesamtdurchsatz in Token pro Sekunde, jede Anfrage mit 300 Ausgabetoken:
| Parallele Anfragen | Ollama | vLLM | Wandzeit Ollama | Wandzeit vLLM |
|---|---|---|---|---|
| 1 | 78,9 | 53,5 | 3,8 s | 5,6 s |
| 4 | 85,6 | 187,7 | 14,0 s | 6,4 s |
| 8 | 83,8 | 364,6 | 28,6 s | 6,6 s |
| 16 | 83,8 | 368,8 | 57,3 s | 13,0 s |
| 32 | 82,9 | 457,8 | 115,8 s | 21,0 s |
Ollama bleibt bei rund 83 Token pro Sekunde stehen, egal wie viele Anfragen kommen. Die Anfragen werden faktisch nacheinander abgearbeitet, die Wartezeit wächst linear mit der Zahl der Nutzer. Bei 32 Anfragen wartet der letzte fast zwei Minuten. Das passt zur Dokumentation: OLLAMA_NUM_PARALLEL steht standardmäßig auf 1, und jede weitere parallele Anfrage vervielfacht den Kontextspeicher, weil Ollama für jeden Slot ein eigenes Kontextfenster reserviert.
vLLM bündelt dagegen gleichzeitige Anfragen per Continuous Batching zu gemeinsamen Durchläufen. Die Gewichte werden pro Schritt einmal gelesen und für alle laufenden Anfragen genutzt. Deshalb bleibt die Wandzeit von einer bis acht Anfragen fast gleich (5,6 gegen 6,6 Sekunden), während sich der Durchsatz knapp versiebenfacht.
Beim dense-Modell flacht die Kurve ab acht parallelen Anfragen ab. Der Grund liegt in Qwen3.8s hybrider Architektur: Jede gleichzeitig dekodierende Sequenz belegt einen festen Zustandsblock der linearen Attention-Schichten, und davon gibt es auf der 4090 nur rund 30 bis 50.
Eine Ungereimtheit will ich nicht verschweigen. Die 89,8 Token pro Sekunde von Ollama liegen über der Bandbreiten-Obergrenze, die ich oben für ein 16-GB-dense-Modell hergeleitet habe. Entweder liest Ollama pro Token weniger Daten, als die Rechnung annimmt, oder die beiden Server zählen die Ausgabetoken unterschiedlich. Ich habe das nicht aufgelöst. Den Single-Stream-Vorsprung von Ollama werte ich deshalb mit Vorsicht, die Last-Messung ist davon unberührt: Die Wandzeiten sind eindeutig.
| Einsatz | Empfehlung |
|---|---|
| Du allein, Chat und gelegentliche Fragen | Ollama |
| Modelle schnell wechseln und ausprobieren | Ollama |
| Coding-Agent mit vielen Tool-Aufrufen | vLLM (kurze TTFT, mehrere Anfragen pro Schritt) |
| Team, n8n-Workflows, mehrere Dienste | vLLM |
| Server, der dauerhaft ein festes Modell bedient | vLLM |
Wie du ein so betriebenes Modell in Editor und Agent einbindest, steht in Lokale Modelle einbinden.
Dense gegen MoE: der eigentliche Durchbruch
Ein MoE-Modell liest pro Token nur die aktiven Experten aus dem Speicher statt aller Gewichte, und damit umgeht es das Bandbreitenlimit, an dem das dense-Modell festhängt. Qwen3-Coder-30B-A3B hat 30 Milliarden Parameter, aktiviert pro Token aber nur rund 3 Milliarden. Das ganze Modell muss trotzdem in den Speicher passen, gelesen wird pro Token aber nur ein Bruchteil.
Gemessen unter vLLM 0.28.0 mit Treiber 610:
| Metrik | dense Qwen3.8-27B (INT4) | MoE Qwen3-Coder-30B-A3B (AWQ) | Faktor |
|---|---|---|---|
| Decode, ein Stream | 53,9 tok/s | 199,6 tok/s | 3,7x |
| TTFT, kurzer Prompt | 0,062 s | 0,025 s | 2,5x |
| Prefill, ~11.500 bzw. 15.104 Token | 2.824 tok/s | 10.899 tok/s | 3,9x |
| Durchsatz bei 8 parallelen Anfragen | 364,6 tok/s | 932,4 tok/s | 2,6x |
| Frage in opencode, Ende zu Ende | 9,4 s | 2,5 s | 3,8x |
Beim Prefill-Vergleich ist die Promptlänge nicht identisch, weil die Tokenizer der beiden Modelle denselben Text unterschiedlich zerlegen: 11.498 Token beim dense-Modell, 15.104 beim MoE-Modell. Beim kürzeren Prompt mit 4.004 Token kam das MoE-Modell auf 14.943 Token pro Sekunde und eine TTFT von 0,27 Sekunden.
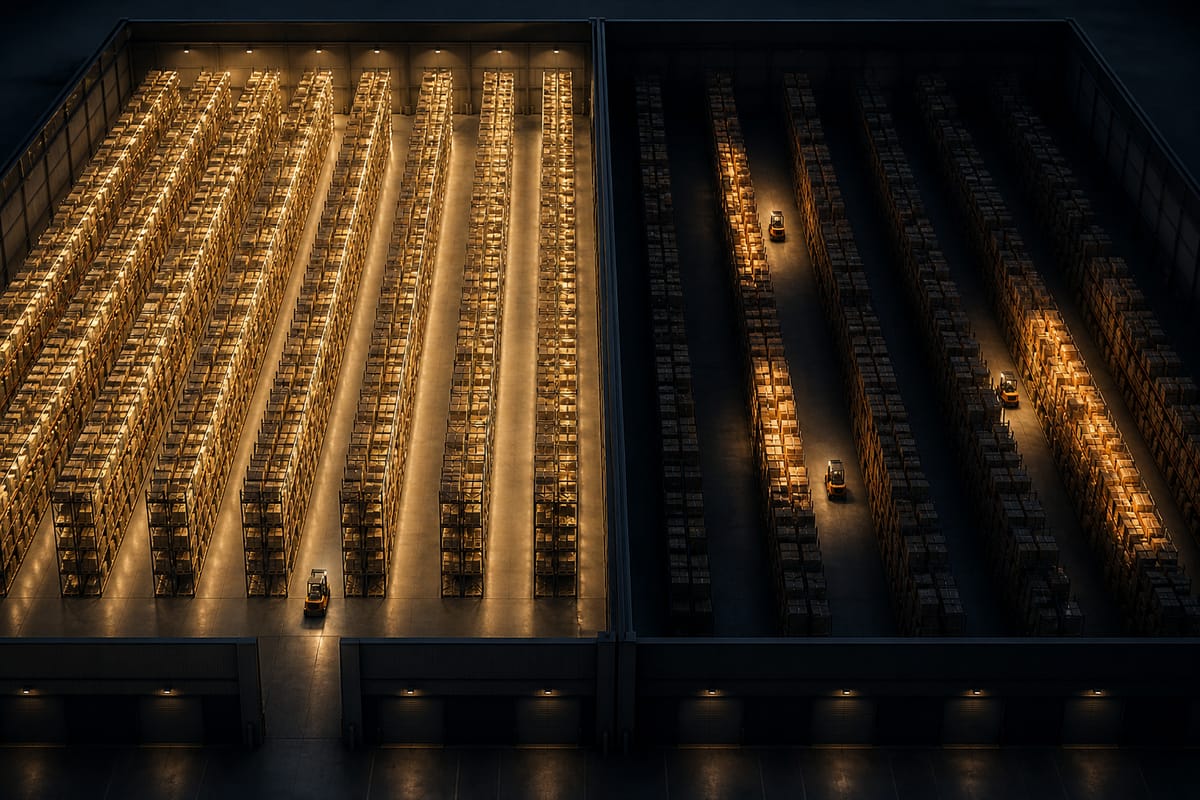
Zwei gleich große, dunkle Lagerhallen nebeneinander. In der linken sind alle Regalreihen hell beleuchtet und ein einzelner Gabelstapler fährt eine lange Strecke durch sämtliche Gänge. In der rechten leuchten nur wenige einzelne Regalreihen, und mehrere kleine Gabelstapler holen dort gleichzeitig Waren ab.
Das Prinzip hinter dem Messunterschied: Ein dense-Modell muss für jedes Token durch das ganze Lager, ein MoE-Modell holt nur aus den wenigen Regalen, die gerade gebraucht werden. Der Platz für das ganze Lager wird trotzdem gebraucht.
Diese Zahlen haben eine Kehrseite, die in Benchmarks gern fehlt. Das MoE-Modell ist ein reines Instruct-Modell ohne Denkphase, und ohne Thinking nimmt es Prompts wörtlicher. Die Frage „Was ist an add falsch?“ hat es als git add verstanden und über Git spekuliert, statt die Datei zu lesen. „Lies calc.py und nenne den Bug in add“ war sofort korrekt. Das dense-Modell war bei mehrdeutigen Prompts robuster. Wer MoE einsetzt, formuliert präziser oder lässt den Agenten präziser formulieren.
Für mich war das Ergebnis trotzdem eindeutig. Seit dem 30. August 2026 läuft auf meinem Server das MoE-Modell statt des dense-Modells. Die gesparte Wartezeit pro Agentenschritt summiert sich über einen Arbeitstag zu mehr, als ich durch gelegentliches Nachschärfen eines Prompts verliere.
Was spekulatives Decoding beim dense-Modell gebracht hätte
Qwen3.8-27B bringt ein MTP-Modul für spekulatives Decoding mit. Ich habe es gemessen: Single-Stream-Decode stieg von 54 auf 83 Token pro Sekunde, also Faktor 1,55. Bei acht parallelen Anfragen fiel der Durchsatz dagegen von 364,6 auf 195,9 Token pro Sekunde, also knapp auf die Hälfte.
Der größere Haken: Die Draft-Gewichte kosten rund 1,5 GiB, und die passen auf der 4090 nicht neben 32k Kontext. Mit MTP muss der Kontext auf rund 16k herunter. Für einen Coding-Agenten ist der halbierte Kontext den Tausch nicht wert, und das MoE-Modell ist ohnehin mehr als doppelt so schnell.
Kontextlänge und KV-Cache: wo die 24 GB wirklich hingehen
Auf einer 24-GB-Karte entscheidet nicht das Modell allein, ob es läuft, sondern das Modell plus der KV-Cache für den gewünschten Kontext, und dieser Rest ist erstaunlich knapp. Der KV-Cache speichert für jedes Token im Kontext die Schlüssel und Werte der Attention-Schichten und wächst linear mit der Kontextlänge. Wie das im Detail funktioniert, erklärt Das Context Window verstehen.
Beim dense-Modell mit 16,6 GB Gewichten bleibt auf der 4090 kaum Luft:
gpu-memory-utilization |
KV-Cache | Reicht für 32k Kontext? |
|---|---|---|
| 0,90 | 1,47 GiB | nein, 32k brauchen 2,3 GiB |
| 0,96 | 2,94 GiB, 41.642 Token | ja |
vLLM reserviert mit --gpu-memory-utilization einen festen Anteil des VRAM für Gewichte, Aktivierungen und KV-Cache. Auf einer 24-GB-Karte mit einem 16-GB-Modell sind die letzten sechs Prozent genau der Unterschied zwischen 32k Kontext und einem Abbruch beim Start.
FP8-KV-Cache: auf der 4090 ein reiner Gewinn
Mit --kv-cache-dtype fp8 speichert vLLM den KV-Cache in 8 statt 16 Bit, und auf der 4090 hat das bei mir den Kontext verdoppelt und den Decode zusätzlich beschleunigt. Die Karte hat Compute Capability 8.9 und rechnet FP8 nativ. Gemessen mit dem MoE-Modell:
| Metrik | KV-Cache 16 Bit | KV-Cache FP8 |
|---|---|---|
| KV-Cache-Kapazität | 39.552 Token | 71.936 Token |
| Nutzbarer Kontext | 32k | 65k |
| Decode, ein Stream | 199,6 tok/s | 219,5 tok/s (+10 %) |
Der Decode wird schneller, weil pro Token nur noch halb so viele KV-Daten gelesen werden müssen. Das ist dieselbe Bandbreiten-Logik wie bei den Gewichten.
vLLM warnt beim Start, FP8 ohne passenden Skalierungsfaktor könne die Genauigkeit senken. Im Tool-Calling-Test habe ich keinen Unterschied gesehen. Bei sehr langen Kontexten behalte ich es im Auge. Wer den Kontext auf diese Weise vergrößert, muss --max-model-len und das Kontextlimit im Client gemeinsam anheben, sonst nutzt niemand den gewonnenen Platz.
Ollama kennt das Gegenstück als OLLAMA_KV_CACHE_TYPE=q8_0. Laut Dokumentation halbiert es den Speicherbedarf des Caches gegenüber f16 bei sehr geringem Präzisionsverlust, setzt Flash Attention voraus und gilt global für alle Modelle. Meine Ollama-Messungen liefen bereits mit dieser Einstellung.
Die Fallen, die erst im Betrieb auftauchen
Diese Punkte haben mich jeweils einen Abbruch gekostet. Sie stehen hier, weil keine Kurzanleitung sie erwähnt:
- Vision-Encoder abschalten. Qwen3.8-27B ist multimodal, der Bild-Encoder reserviert ein Budget von 16k Token und führt beim Speicher-Profiling zum Abbruch.
--limit-mm-per-prompt '{"image":0,"video":0}'spart rund 1,1 GB. -
--max-num-seqsbegrenzen. Der Standardwert 1024 erzeugt mit Qwens Vokabular von 248.000 Token riesige Logits-Tensoren. Beim dense-Modell lief es mit 48 stabil. - Beim MoE-Modell nicht auf 0,96 gehen. Der Start klappt, aber mitten im Betrieb sprengen die Aktivierungen der Experten den Puffer, und vLLM meldet
memory mapping failed with OOM. Mit--gpu-memory-utilization 0.92und--max-num-seqs 32läuft es stabil. - Ollama und vLLM nicht parallel starten. Zwei Modelle in 24 GB gehen nicht. Ein systemd-
Conflicts=verhindert, dass ein Neustart den anderen Dienst stillschweigend aushungert. - Portwechsel bedenken. Ollama lauscht auf 11434, vLLM auf 8000. Skripte und Workflows, die fest auf 11434 zeigen, brechen beim Umstieg.
Welche Hardware für einen Ollama- oder LLM-Server?
Für einen lokalen LLM-Server zählen zwei Werte: wie viel Speicher die GPU direkt adressiert und mit welcher Bandbreite sie ihn liest. Der Speicher entscheidet, welches Modell mit wie viel Kontext überhaupt lädt. Die Bandbreite entscheidet, wie schnell es antwortet. Die Rechenleistung ist zweitrangig, solange sie für einen flotten Prefill reicht.
| System | Speicher für das Modell | Bandbreite | Rechnerische Obergrenze bei 16 GB/Token | Preis |
|---|---|---|---|---|
| RTX 3090 | 24 GB | 936 GB/s | ~58 tok/s | 1.499 USD Listenpreis 2020 |
| RTX 4090 | 24 GB | 1.008 GB/s | ~63 tok/s, gemessen 54 | 1.599 USD Listenpreis 2022 |
| RTX 5090 | 32 GB | 1.792 GB/s | ~112 tok/s | 2.099 € UVP, im Handel ab 4.850 € (1. Sept. 2026) |
| NVIDIA DGX Spark | 128 GB (geteilt) | 273 GB/s | ~17 tok/s | 6.950 USD (Okt. 2026) |
| Mac Studio M5 Max | bis 128 GB (geteilt) | 460 bzw. 614 GB/s | ~29 bzw. ~38 tok/s | ab 2.999 € |
| Mac Studio M5 Ultra | 96 bis 512 GB (geteilt) | 1.200 GB/s | ~75 tok/s | ab 6.599 € |
Die vorletzte Spalte ist keine Messung, sondern die Bandbreite geteilt durch 16 GB, also die Datenmenge, die ein dense-Modell der 27B-Klasse in 4 Bit pro Token liest. Sie gibt eine Obergrenze an. Real liegt der Wert darunter, auf meiner 4090 unter vLLM bei rund 80 bis 85 Prozent davon. Bei Systemen mit geteiltem Speicher geht außerdem ein Teil an Betriebssystem und Anwendungen. Ein MoE-Modell liegt bei allen Systemen deutlich darüber, weil es pro Token weniger liest.
Die Preise schwanken 2026 stark. Laut PC Games Hardware lag die günstigste RTX 5090 in Deutschland am 1. September 2026 bei 4.850 Euro, mehr als das Doppelte des Preises von September 2025. Als Grund nennt der Bericht vor allem gestiegene Kosten für GDDR7-Speicher. Auch der DGX Spark mit 128 GB ist laut The Register inzwischen rund 75 Prozent teurer als zum Start.
Was die Tabelle bedeutet
RTX 3090 und 4090 sind für Modelle bis etwa 32 Milliarden Parameter in 4 Bit gleichwertig, was den Speicher angeht. Die 4090 hat rund acht Prozent mehr Bandbreite und vor allem FP8-Unterstützung, die beim KV-Cache den Kontext verdoppelt hat. Für einen Server mit einem MoE-Modell der 30B-Klasse ist eine 24-GB-Karte die wirtschaftlichste Wahl.
Die RTX 5090 bringt 32 GB und fast die doppelte Bandbreite der 4090. Die 8 GB mehr schaffen Luft für längeren Kontext oder für MTP-Spekulation, die auf der 4090 nicht neben 32k Kontext passt, weil dort knapp 1 GiB fehlt. Zum aktuellen Straßenpreis ist sie aber schwer zu rechtfertigen, wenn ein MoE-Modell auf der 4090 schon knapp 200 Token pro Sekunde liefert.
DGX Spark und Mac Studio sind die Wahl, wenn das Modell schlicht nicht in 24 oder 32 GB passt. 128 GB geteilter Speicher und mehr laden Modelle, an die auf einer Consumer-Karte nicht zu denken ist. Der Preis dafür ist die Bandbreite: Der DGX Spark liest mit 273 GB/s weniger als ein Drittel dessen, was die 4090 schafft. Für ein großes dense-Modell bedeutet das langsame Ausgabe. Mit einem MoE-Modell, das wenige Parameter pro Token aktiviert, wird diese Klasse wieder interessant. Der Mac Studio mit M5 Ultra hat unter den Systemen mit großem Speicher die höchste Bandbreite.
Der Rest des Servers
Die GPU ist nicht alles. Mein Server hat 125 GB Arbeitsspeicher und 32 Kerne. Das ist großzügig, aber nicht überdimensioniert: Modelle werden beim Laden aus dem RAM in den VRAM geschoben, mehrere Modelle liegen als Dateien bereit, und wenn ein Modell doch nicht ganz in den VRAM passt, lagert Ollama Schichten in den Arbeitsspeicher aus. Dann bricht die Ausgabe allerdings um eine Größenordnung ein, wie der Artikel zur Modellauswahl beschreibt. Für Modelldateien von 18 bis 19 GB je Stück gehört eine schnelle NVMe-SSD dazu.
Empfehlung nach Einsatz
| Einsatz | Hardware | Laufzeit | Modelltyp |
|---|---|---|---|
| Ausprobieren, Chat für dich allein | vorhandene GPU ab 8 GB oder Mac mit Apple Silicon | Ollama | kleines dense-Modell |
| Coding-Agent für eine Person | 24 GB (RTX 3090 oder 4090) | vLLM | MoE der 30B-Klasse, FP8-KV-Cache |
| Kleines Team, interne Workflows | 24 bis 32 GB | vLLM | MoE |
| Große Modelle ab 70B, Tempo zweitrangig | 128 GB geteilter Speicher (DGX Spark, Mac Studio) | Ollama oder llama.cpp | MoE bevorzugt |
| Viele Nutzer, große Modelle | Mehrere GPUs oder Server-Karten | vLLM | je nach Lizenz und Bedarf |
Häufige Fragen
Welche Hardware brauche ich für Ollama? Für Ollama zählt vor allem der Speicher, auf den die GPU direkt zugreift: bei NVIDIA der VRAM, bei Apple Silicon der gemeinsame Arbeitsspeicher. Ab 8 GB laufen kleine Modelle, ab 24 GB Modelle bis rund 32 Milliarden Parameter in 4 Bit. Welches Modell zu welcher Speicherklasse passt, steht im Artikel zur Modellauswahl.
Wie schnell ist eine RTX 4090 mit lokalen LLMs? Auf meinem Server erreichte ein dense-Modell mit 27 Milliarden Parametern unter vLLM 53,9 Token pro Sekunde, ein MoE-Modell mit 3 Milliarden aktiven Parametern 199,6 Token pro Sekunde, mit FP8-KV-Cache 219,5. Unter Ollama lag das dense-Modell bei 89,8 Token pro Sekunde für einen einzelnen Stream. Alle Werte gelten mit Treiber 610.
Ist vLLM schneller als Ollama? Für einen einzelnen Nutzer nicht unbedingt, in meiner Messung lag Ollama dort sogar vorn. Bei mehreren gleichzeitigen Anfragen ist vLLM klar überlegen: Bei acht parallelen Anfragen lieferte es 364,6 statt 83,8 Token pro Sekunde, die Wandzeit sank von 28,6 auf 6,6 Sekunden.
Reichen 24 GB VRAM für einen LLM-Server? Für ein MoE-Modell der 30B-Klasse mit 65k Kontext ja, sofern du FP8-KV-Cache nutzt. Für ein dense-Modell der 27B-Klasse reicht es für 32k Kontext, aber nur mit fein eingestellter Speicherreservierung. Spekulatives Decoding passt daneben nicht mehr.
Lohnt sich eine RTX 5090 statt einer 4090 für LLMs? Technisch ja: 32 statt 24 GB und 1.792 statt 1.008 GB/s Bandbreite. Zum Straßenpreis von rund 4.850 Euro im September 2026 lohnt sie sich aber nur, wenn ein Modell auf 24 GB nicht passt. Für ein MoE-Modell ist die 4090 bereits schnell genug.
Ist ein Mac oder der DGX Spark besser als eine Grafikkarte? Sie sind besser, wenn das Modell größer als 24 oder 32 GB ist. Sie sind schlechter, wenn es um Ausgabetempo bei Modellen geht, die auch auf eine Grafikkarte passen, weil ihre Bandbreite niedriger ist. Der DGX Spark liegt bei 273 GB/s, der Mac Studio mit M5 Max bei 460 bis 614 GB/s, die RTX 4090 bei 1.008 GB/s.
Warum ist mein lokales Modell plötzlich langsam? Meist passt das Modell samt Kontext nicht mehr ganz in den VRAM, und Teile laufen auf der CPU. Prüf außerdem die Treiberversion. Auf meinem Server hat der Wechsel von Treiber 535 auf 610 den Prefill um den Faktor 3,5 beschleunigt.
Zusammenfassung und praktische Tipps
- Bandbreite bestimmt die Ausgabegeschwindigkeit. Bandbreite geteilt durch die pro Token gelesenen Gigabyte ergibt die Obergrenze, auf der 4090 bei einem 27B-dense-Modell rund 60 Token pro Sekunde.
- Treiber zuerst prüfen. 535 auf 610 brachte unter Ollama Faktor 3,5 beim Prefill und 24 Prozent beim Decode, und vLLM ab 0.26 läuft ohne Treiber 580 oder neuer gar nicht.
- MoE statt dense, wenn Tempo zählt. Qwen3-Coder-30B-A3B lief 3,7-mal so schnell wie das dense Qwen3.8-27B, bei ähnlichem Speicherbedarf.
- Ollama für dich allein und zum Ausprobieren. Der Durchsatz bleibt bei rund 83 Token pro Sekunde, egal wie viele Anfragen warten.
- vLLM ab zwei gleichzeitigen Nutzern oder für Agenten. Bei acht parallelen Anfragen lieferte es das 4,3-Fache.
- FP8-KV-Cache auf der 4090 einschalten. Doppelter Kontext und zehn Prozent schnellerer Decode, im Test ohne erkennbaren Qualitätsverlust.
gpu-memory-utilizationbewusst setzen. 0,96 für das dense-Modell, 0,92 für MoE, sonst OOM beim Start oder mitten im Betrieb.- Kontext ist Speicher. Ein langer Kontext kostet VRAM, und auf 24 GB ist er oft das Erste, was knapp wird.
- 24 GB sind die sinnvolle Untergrenze für einen Server. Darüber entscheidet die Modellgröße, ob 32 GB oder 128 GB geteilter Speicher nötig sind.
- Prompts für MoE-Instruct-Modelle präzise formulieren. Ohne Denkphase nehmen sie Fragen wörtlicher.
Mein Rat: Kauf keine teurere Grafikkarte, bevor du die vorhandene richtig eingestellt hast. Auf meinem Server kamen die großen Sprünge von einem Treiber-Update, einem anderen Modelltyp und einer anderen Laufzeitumgebung. Keiner davon hat Geld gekostet. Eine RTX 4090 mit aktuellem Treiber, vLLM und einem MoE-Modell liefert knapp 200 Token pro Sekunde und reicht für einen Coding-Agenten und ein kleines Team. Die RTX 5090 und die Systeme mit großem geteiltem Speicher kaufst du erst, wenn das Modell, das du wirklich brauchst, nicht mehr in 24 GB passt.
Ressourcen
- GeForce RTX 40 series – Wikipedia – Speicher, Listenpreis und Starttermin der RTX 4090
- NVIDIA GeForce RTX 4090 Founders Edition Review – ServeTheHome – Busbreite und Speichertakt, aus denen sich die 1.008 GB/s ergeben
- GeForce RTX 50 series – Wikipedia – Speicher, Bandbreite und Listenpreis der RTX 5090
- GeForce 30 series – Wikipedia – Speicher, Bandbreite und Listenpreis der RTX 3090
- Geforce RTX 5090 kostet jetzt 5.099 US-Dollar – PC Games Hardware, 1. September 2026 – aktuelle Straßenpreise der RTX 5090 in Deutschland und die Gründe dafür
- Nvidia DGX Spark: neue 64-GB-Version, 128 GB teurer – The Register, 2. Oktober 2026 – Preise und Bandbreite des DGX Spark
- Mac Studio – Technische Daten, Apple – Speicherbandbreite und Speicheroptionen von M5 Max und M5 Ultra
- Mac Studio mit M5 Max und M5 Ultra – Macwelt – deutsche Startpreise und Basiskonfigurationen
- Ollama FAQ –
OLLAMA_NUM_PARALLEL, Flash Attention und KV-Cache-Quantisierung - Quantized KV Cache – vLLM-Dokumentation – wie vLLM den KV-Cache in FP8 speichert
- Welches Ollama-Modell? Auswahl nach Hardware und Zweck – welches Modell auf welche Speicherklasse passt
- Quantisierung von LLMs erklärt – GGUF, GPTQ und AWQ im Vergleich
- Ollama installieren: macOS, Linux, Windows und Docker – der Weg zur ersten lokalen Installation
- Eine lokale ChatGPT-Alternative selbst hosten – Chat-Oberfläche für Ollama mit Open WebUI
- Qwen3.8-27B gegen die Cloud – das dense-Modell aus den Messungen im Detail
- Das Context Window verstehen – warum langer Kontext Speicher kostet
- Lokale Modelle einbinden – das gemessene Modell in Editor und Agent nutzen
- Eine lokale ChatGPT-Alternative selbst hosten: Komplett offline mit Open WebUI und Ollama
- Welches Ollama-Modell? Auswahl nach Hardware und Zweck
- Ollama installieren: macOS, Linux, Windows und Docker
- Ollama: lokale Sprachmodelle auf dem eigenen Rechner betreiben
- Ollama auf Deutsch: Welche lokalen Modelle gutes Deutsch schreiben (Stand November 2026)
- Ollama Cloud vs. ChatGPT Plus: Preise, Modelle, Datenschutz und wann lokale Hardware gewinnt