
Roboter, die aus Vormachen lernen: Vision-Language-Action-Modelle mit LeRobot
Artikel-Übersicht
In Einen Roboterarm per Software steuern habe ich beschrieben, wie man einem Arm Posen, Bahnen und Abläufe beibringt: Jede Bewegung ist dort explizit – geteacht, gespeichert, abgespielt. Das funktioniert hervorragend, solange die Welt stillhält. Liegt das Teil zwei Zentimeter weiter links, greift der Arm daneben. Imitation Learning dreht das Prinzip um: Du machst die Aufgabe ein paar Dutzend Mal vor, und ein neuronales Netz lernt daraus, aus Kamerabildern und Gelenkstellung selbst die nächste Bewegung abzuleiten – auch dann, wenn das Teil woanders liegt.
Die wichtigste offene Bibliothek dafür ist LeRobot von Hugging Face, seit Juli 2026 in Version 0.6. Dieser Artikel geht den kompletten Weg durch: das Prinzip von Leader- und Follower-Arm, das Datenformat, die Aufnahme guter Demonstrationen, das Training und die Ausführung auf dem Roboter, jeweils mit den genauen Kommandos. Ein Vergleich ordnet die wichtigsten Lernverfahren ein, von den kleinen, schnell trainierten Policies wie ACT bis zu den großen Vision-Language-Action-Modellen (VLA), die zusätzlich eine Anweisung in natürlicher Sprache verstehen. Grundlage sind die offizielle LeRobot-Dokumentation, die Release-Notes, die Modellkarten und Paper der jeweiligen Modelle sowie Seeeds Anleitung für den reBot Arm B601-RS, Stand 10. Oktober 2026.
Wenn dir Begriffe wie neuronales Netz, Training und Inferenz noch unscharf sind, hilft KI, maschinelles Lernen, Deep Learning: die Abgrenzung als Einstieg.
Das Prinzip: vormachen, aufzeichnen, nachahmen
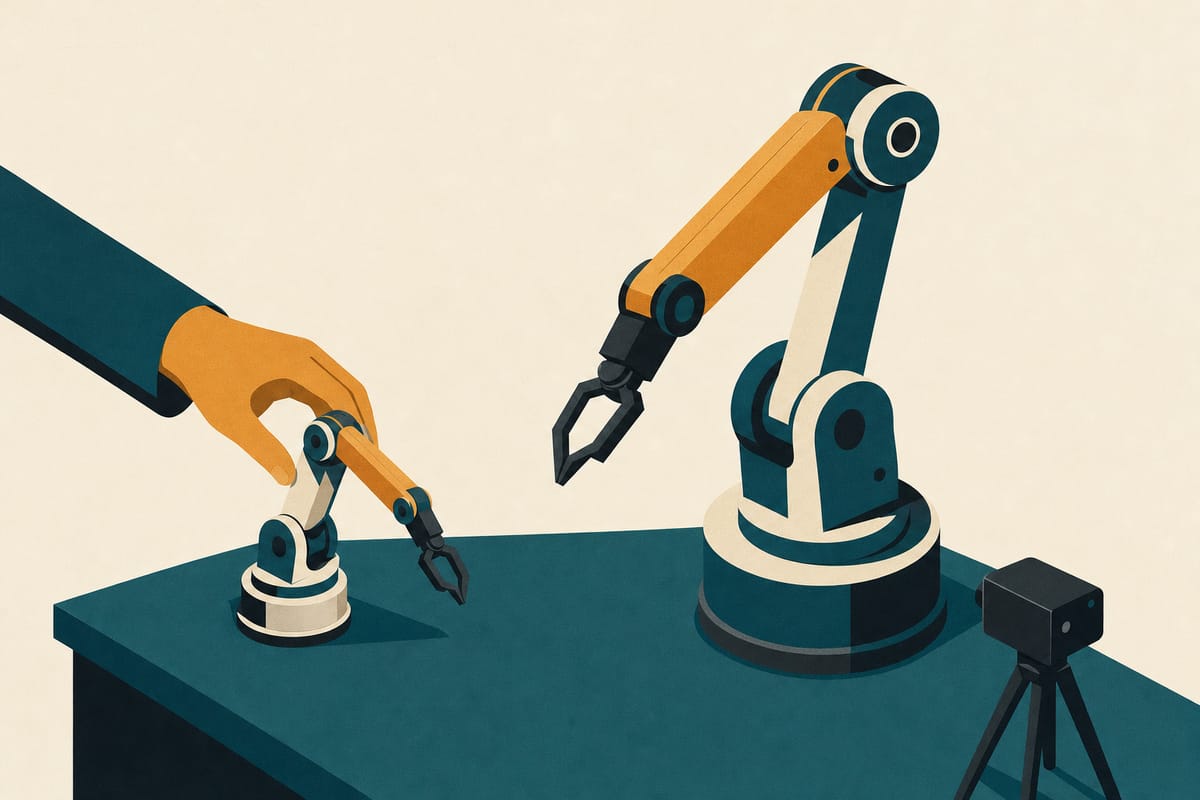
Imitation Learning heißt: Ein Mensch steuert den Roboter, das System zeichnet gleichzeitig auf, was die Kameras sehen und was die Motoren tun – und ein Netz lernt die Zuordnung von „Bild und Stellung" zu „nächste Bewegung". Gesteuert wird meist über einen zweiten, kleineren Arm, den Leader. Du bewegst ihn mit der Hand, der eigentliche Roboter, der Follower, folgt ihm Gelenk für Gelenk.
  Aufnahme (Teleoperation)                         Ausführung (Policy)

  ┌──────────┐  Gelenkwinkel  ┌──────────┐         ┌─────────┐   Bilder + Zustand
  │  Leader  │ ─────────────► │ Follower │         │ Kameras │ ───────┐
  │ (Hand)   │                │ (Robot)  │         └─────────┘        ▼
  └──────────┘                └────┬─────┘                     ┌─────────────┐
       ▲                           │                           │   Policy    │
       │                           ▼                           │ (trainiert) │
  ┌─────────┐   Bilder     ┌──────────────┐                    └──────┬──────┘
  │ Kameras │ ───────────► │  Datensatz   │ ──► Training ──►         │ Aktionen
  └─────────┘              │ Bild, Zustand│                           ▼
                           │ Aktion, Text │                    ┌──────────┐
                           └──────────────┘                    │ Follower │
                                                               └──────────┘
Der Unterschied zum klassischen Teaching aus dem Steuerungsartikel ist grundsätzlich: Dort speichert man eine Bahn und spielt genau diese ab. Hier speichert man viele Demonstrationen mit Variation – Objekt mal links, mal rechts, mal schräg – und das Netz lernt, die Bewegung an die Situation anzupassen, die es auf den Kamerabildern sieht.
LeRobot im Überblick
LeRobot ist eine PyTorch-Bibliothek von Hugging Face, die Hardware-Treiber, ein einheitliches Datenformat, fertige Lernverfahren und Kommandozeilenwerkzeuge für den ganzen Ablauf zusammenbringt. Sie steht unter Apache 2.0.
| Version | Datum | Wichtigste Neuerung |
|---|---|---|
| 0.4.0 | 23.10.2025 | Datenformat LeRobotDataset v3.0 |
| 0.5.0 | 09.03.2026 | – |
| 0.6.0 | 06.07.2026 | World-Model-Policies, neue VLAs, Reward-Modelle, lerobot-rollout |
| 0.6.1 | 03.08.2026 | aktueller Stand |
Direkt unterstützt werden unter anderem SO-100/101, Koch, LeKiwi, HopeJR, OpenARM, Reachy 2, Unitree G1 und der reBot B601. Weitere Arme wie xArm, UR5e, Franka oder AgileX Piper kommen über Community-Plugins dazu.
Was Version 0.6 gebracht hat
- Neue Policies: GR00T N1.7 von NVIDIA (ersetzt N1.5), MolmoAct2 vom Allen Institute for AI, EO-1, Multitask DiT, EVO1 sowie erstmals World-Model-Policies (VLA-JEPA, FastWAM, LingBot-VA), die beim Training zusätzlich lernen, wie sich die Welt verändert.
lerobot-rollout: ein eigenes Kommando, um eine trainierte Policy auf dem Roboter auszuführen, mit verschiedenen Strategien und Real-Time Chunking für langsame Modelle.- Reward-Modelle: eine einheitliche API, mit der man bewerten lassen kann, ob ein Versuch erfolgreich war – Grundlage für späteres Nachlernen.
- Benchmarks:
lerobot-evaldeckt neun Simulations-Benchmark-Familien ab, darunter LIBERO, Meta-World und RoboCasa365. - Daten und Training: Tiefenbilder von RealSense-Kameras, Sprach-Annotationen, verteiltes Training über FSDP und Cloud-Training über Hugging Face Jobs.
- Schlankere Installation:
pip install lerobothat rund 40 Prozent weniger Abhängigkeiten; was man zum Trainieren braucht, kommt über Extras wie[training].
Achtung beim Umstieg: Version 0.6 hat Parameter umbenannt (unter anderem eval_freq → env_eval_freq, --dataset.vcodec → --dataset.rgb_encoder.vcodec) und setzt PyTorch 2.7 voraus. Wer GR00T N1.5 braucht, muss bei lerobot==0.5.1 bleiben.
Das Datenformat
Ein LeRobotDataset v3.0 speichert Zustände und Aktionen in Parquet-Dateien und jede Kamera als MP4-Video. Viele Episoden teilen sich eine Datei, die Grenzen stehen in den Metadaten. Dazu kommen meta/info.json (Struktur, Frequenz, Kameras), meta/stats.json (Statistiken zur Normalisierung) und meta/tasks.jsonl (die Aufgabenbeschreibungen in Text). Datensätze lassen sich direkt vom Hugging Face Hub streamen, ohne sie vorher herunterzuladen.
Der Ablauf Schritt für Schritt
Der Weg vom ausgepackten Arm zur trainierten Policy hat sechs Schritte, und für jeden gibt es ein eigenes Kommando. Die Beispiele zeigen den SO-101, den günstigsten und am besten dokumentierten Arm. Die Unterschiede für den reBot B601-RS folgen im nächsten Abschnitt.
1. Kalibrieren
lerobot-calibrate --robot.type=so101_follower --robot.port=/dev/ttyACM0 \
                  --robot.id=mein_follower
lerobot-calibrate --teleop.type=so101_leader --teleop.port=/dev/ttyACM1 \
                  --teleop.id=mein_leader
Beim Kalibrieren bringst du zuerst alle Gelenke in die Mitte ihres Bereichs und bewegst dann jedes einmal durch seinen vollen Bereich. Die id ist wichtiger, als sie aussieht: Sie bestimmt, welche Kalibrierdatei geladen wird, und muss bei Teleoperation, Aufnahme und Ausführung identisch sein. Eine Policy, die mit einer anderen Kalibrierung trainiert wurde, fährt systematisch daneben.
2. Teleoperieren und Kameras prüfen
lerobot-teleoperate \
  --robot.type=so101_follower --robot.port=/dev/ttyACM0 --robot.id=mein_follower \
  --teleop.type=so101_leader --teleop.port=/dev/ttyACM1 --teleop.id=mein_leader \
  --robot.cameras="{ top: {type: opencv, index_or_path: 0, width: 640, height: 480, fps: 30},
                     wrist: {type: opencv, index_or_path: 1, width: 640, height: 480, fps: 30} }" \
  --display_data=true
Hier übst du die Aufgabe, bevor du aufnimmst. Mit --display_data=true siehst du die Kamerabilder live – seit 0.6 auch in Foxglove (--display_mode=foxglove).
3. Demonstrationen aufnehmen
hf auth login --token ${HUGGINGFACE_TOKEN} --add-to-git-credential

lerobot-record \
  --robot.type=so101_follower --robot.port=/dev/ttyACM0 --robot.id=mein_follower \
  --teleop.type=so101_leader --teleop.port=/dev/ttyACM1 --teleop.id=mein_leader \
  --robot.cameras="{ top: {...}, wrist: {...} }" \
  --dataset.repo_id=${HF_USER}/wuerfel_in_schale \
  --dataset.single_task="Lege den roten Würfel in die blaue Schale" \
  --dataset.num_episodes=50 \
  --dataset.episode_time_s=30 --dataset.reset_time_s=20
Während der Aufnahme steuern Tasten den Ablauf: Pfeil rechts oder n beendet die Episode vorzeitig, Pfeil links oder r nimmt sie neu auf, Esc oder q beendet alles und lädt hoch. Zwischen zwei Episoden bleibt die reset_time_s, um die Szene neu aufzubauen. Abgebrochene Aufnahmen setzt man mit --resume=true fort.
4. Datensatz prüfen
lerobot-replay --dataset.repo_id=${HF_USER}/wuerfel_in_schale --dataset.episode=0 ...
lerobot-dataset-viz        # Videos und Gelenkverläufe einer Episode ansehen
lerobot-replay spielt eine Episode auf dem Arm ab, lerobot-dataset-viz zeigt Videos und Gelenkverläufe. Schlechte Episoden jetzt zu finden, spart Stunden im Training.
5. Trainieren
lerobot-train \
  --dataset.repo_id=${HF_USER}/wuerfel_in_schale \
  --policy.type=act \
  --output_dir=outputs/train/act_wuerfel \
  --job_name=act_wuerfel \
  --policy.device=cuda \
  --policy.repo_id=${HF_USER}/act_wuerfel
Auf einem Mac mit Apple Silicon setzt du --policy.device=mps, was aber deutlich langsamer ist. Ohne eigene GPU geht es in die Cloud: --job.target=a10g-small startet das Training als Hugging Face Job. Für ein vortrainiertes VLA statt ACT tauschst du die Policy aus, etwa --policy.path=lerobot/smolvla_base.
6. Auf dem Roboter ausführen
lerobot-rollout \
  --strategy.type=base \
  --policy.path=${HF_USER}/act_wuerfel \
  --robot.type=so101_follower --robot.port=/dev/ttyACM0 --robot.id=mein_follower \
  --robot.cameras="{ top: {...}, wrist: {...} }" \
  --task="Lege den roten Würfel in die blaue Schale" \
  --duration=60
Mit --strategy.type=sentry und einer --dataset.repo_id werden die Versuche gleichzeitig aufgezeichnet – nützlich, um Erfolgsquoten zu messen. Für langsame VLAs wie π0 oder SmolVLA sorgt --inference.type=rtc dafür, dass der Arm nicht auf das Modell warten muss.
Der Sonderfall reBot Arm B601-RS
Den B601-RS unterstützt Seeed über eigene Zusatzpakete, nicht über den Treiber, der in LeRobot selbst steckt. Die offizielle LeRobot-Doku kennt nur die Variante B601-DM mit Damiao-Motoren (rebot_b601_follower). Für die RS-Variante mit RobStride-Motoren installiert man Seeeds Plugins:
pip install -e ./lerobot
pip install lerobot-robot-seeed-b601 lerobot-teleoperator-rebot-arm-102 motorbridge

sudo ip link set can0 type can bitrate 1000000 && sudo ip link set can0 up
sudo chmod 666 /dev/ttyUSB0          # Leader-Arm (seriell)

lerobot-calibrate --robot.type=seeed_b601_rs_follower --robot.port=can0 \
                  --robot.id=follower1 --robot.can_adapter=socketcan
lerobot-calibrate --teleop.type=rebot_arm_102_leader --teleop.port=/dev/ttyUSB0 \
                  --teleop.id=rebot_arm_102_leader
Der Follower wird in der Nullstellung mit geschlossenem Greifer kalibriert. Seeed nennt als Umgebung Ubuntu 22.04 oder 24.04 mit Python 3.12, empfiehlt mindestens 50 Episoden, etwa zehn pro Objektposition, fest montierte Kameras und höchstens drei Kameras mit 1080p bei 30 fps – nicht zwei an demselben USB-Hub. Laufen Gelenke des Leaders falsch herum, lässt sich die Richtung über --teleop.joint_directions umkehren.
Zwei Dinge sollte man wissen. Erstens ist Seeeds Anleitung beim Stand von Oktober 2026 noch auf älterem LeRobot-Niveau: Sie führt Policies noch über lerobot-record --policy.path aus statt über lerobot-rollout, beschreibt GR00T noch als N1.5 und nennt PyTorch 2.6, während LeRobot 0.6 mindestens 2.7 verlangt. Wer die Plugins mit LeRobot 0.6 kombiniert, sollte mit Anpassungen rechnen. Zweitens beschreibt die Seeed-Anleitung eine Sicherheitsregel, die ich aus eigener Erfahrung unterschreibe: Nach jeder Strom- oder Signalunterbrechung das Programm stoppen und beide Arme in die Ausgangsstellung bringen, bevor es weitergeht.
Was die Hardware kostet: Seeed hat den B601-RS im Juni 2026 mit einem Frühbucherpreis von 1.499 US-Dollar vorgestellt; der Leader-Arm wird separat gekauft, ein 48-V-Netzteil kommt dazu. Der SO-101 zum Vergleich kostet als Teileliste rund 226 Euro für Leader und Follower zusammen.
Welche Policy? ACT, Diffusion und die VLAs
Die Wahl der Policy ist ein Abwägen zwischen Datenbedarf, Hardware und dem, was das Modell verstehen soll: Kleine Policies wie ACT lernen eine Aufgabe schnell auf einer Consumer-GPU, große VLAs verstehen Sprachanweisungen und verallgemeinern besser, brauchen aber viel mehr Rechenleistung.
| Policy | Größe | Eingaben | Training | Inferenz | Demos |
|---|---|---|---|---|---|
| ACT | ca. 80 Mio. | Kameras + Zustand, keine Sprache | 2–6 GB VRAM, 30–60 min auf RTX 4090 | sehr schnell | ca. 50 |
| Diffusion Policy | – | Kameras + Zustand | 8–14 GB VRAM, 2–4 h auf RTX 4090 | langsamer (mehrere Entrauschungsschritte) | – |
| SmolVLA | 450 Mio. | Kameras + Zustand + Sprache | 1–2 h auf A100, 3–6 h auf L4/A10G | ca. 2 GB | ca. 50; 25 zu wenig |
| π0 | ca. 3,3 Mrd. | 2–3 Kameras + Zustand + Sprache | 24–40 GB VRAM, 4–8 h auf A100 40 GB | ca. 14 GB, 73 ms auf RTX 4090 | je nach Aufgabe |
| GR00T N1.7 | 3 Mrd. | Bild + Zustand + Sprache + Roboter-Kennung | 24–40 GB VRAM | 27,9 ms auf H100 mit TensorRT | – |
| MolmoAct2 | 5 Mrd. | Bilder + Sprache | LoRA 20 GB, voll 48 GB | ca. 12 GB, ca. 180 ms | < 200: nur LoRA |
Die Zeiten sind Größenordnungen aus dem Hardware-Leitfaden der LeRobot-Doku und den Modellkarten; die Doku selbst nennt ±50 Prozent als Toleranz. Ein reines Training auf der CPU rät die Doku ab, auf einem Apple-M-Max dauert ACT 6 bis 14 Stunden.
ACT: der pragmatische Einstieg
ACT (Action Chunking with Transformers) stammt aus dem ALOHA-Projekt von 2023 und ist bis heute der beste Startpunkt. Mit rund 80 Millionen Parametern, einem ResNet-18 für die Bilder und einem Transformer für die Aktionen trainiert es auf einer einzelnen Gaming-GPU in unter einer Stunde. Es versteht keine Sprache – jede Aufgabe braucht ein eigenes Modell –, lernt aber aus etwa 50 Demonstrationen erstaunlich robuste Bewegungen.
VLAs: Sprache, Bild und Aktion in einem Modell
Ein Vision-Language-Action-Modell kombiniert ein vortrainiertes Bild-Sprach-Modell mit einem angehängten „Action-Experten", der aus dessen Verständnis kontinuierliche Gelenkbewegungen erzeugt. Der Aufbau am Beispiel von π0:
  Kamerabilder ──┐
                 ├──► Vision-Language-Modell ──► Action-Experte ──► 50 Aktionen
  Anweisung   ───┤     (PaliGemma 3B,              (300 Mio.,         (ein „Chunk")
  „Lege den      │      vortrainiert auf            Flow Matching,
   Würfel …"     │      Bild + Text)                10 Schritte)
  Gelenkzustand ─┘
Der Action-Experte nutzt Flow Matching, eine Variante der Diffusionsmodelle: Er beginnt mit Rauschen und verfeinert es in wenigen Schritten zu einer glatten Bewegungsfolge. Der Vorteil gegenüber ACT liegt im Vortraining: π0 hat über 10.000 Stunden Roboterdaten gesehen, SmolVLA wurde auf 487 Community-Datensätzen mit rund 10 Millionen Frames vortrainiert. Ein solches Modell bringt also schon ein Grundverständnis von Greifen und Ablegen mit und muss für deine Aufgabe nur noch feinjustiert werden. Und es versteht eine Anweisung: Dasselbe Modell kann „Lege den roten Würfel in die Schale" und „Lege den blauen Würfel in die Schale" unterscheiden.
Wie das Bild-Sprach-Modell im Inneren arbeitet, erklärt Transformer-Architektur; wie Bedeutung in Vektoren landet, Embeddings verständlich erklärt.
SmolVLA: das VLA für normale Hardware
SmolVLA ist mit 450 Millionen Parametern das VLA, das auf normaler Hardware Sinn ergibt. Es nutzt nur die ersten 16 Schichten des Sprachmodells SmolVLM2, reduziert jedes Bild auf 64 Tokens und hat einen Action-Experten von rund 100 Millionen Parametern. Im Paper schneidet es auf echten Low-Cost-Armen besser ab als deutlich größere Modelle:
| Arm | SmolVLA | π0 | ACT |
|---|---|---|---|
| SO-100 | 78,3 % | 61,7 % | 48,3 % |
| SO-101 (bekannte Bedingungen) | 90 % | – | 70 % |
| SO-101 (neue Bedingungen) | 50 % | – | 40 % |
Die letzte Zeile ist die ehrliche: Unter Bedingungen, die im Training nicht vorkamen, halbiert sich die Erfolgsquote auch beim besseren Modell. Imitation Learning verallgemeinert, aber nicht beliebig.
Die großen Modelle
π0 und sein Nachfolger π0.5 von Physical Intelligence, GR00T N1.7 von NVIDIA und MolmoAct2 vom Allen Institute sind die Spitzenklasse. Sie brauchen fürs Training Rechenzentrums-GPUs mit 24 bis 80 GB und für die Inferenz eine kräftige Consumer-GPU. MolmoAct2 bietet einen Checkpoint, der ohne eigenes Training auf SO-100/101 laufen soll; unabhängig bestätigt ist dessen Erfolgsquote bisher nicht. Bei GR00T ist die Lizenz zu beachten: Es steht unter der NVIDIA Open Model License, nicht unter Apache 2.0.
Action Chunking: warum Policies in Paketen denken
Moderne Policies sagen nicht eine Aktion pro Bild voraus, sondern eine ganze Folge – bei ACT 100, bei π0 und SmolVLA 50 Schritte. Das hat zwei Gründe. Erstens wird die Bewegung glatter, weil das Modell einen zusammenhängenden Abschnitt plant statt Schritt für Schritt zu zittern. Zweitens gleicht es die Rechenzeit aus: Ein Modell, das 73 ms für eine Vorhersage braucht, könnte bei einer Aktion pro Aufruf nur mit etwa 14 Hz steuern.
ACT mittelt zusätzlich überlappende Vorhersagen mit exponentiell abnehmenden Gewichten (Temporal Ensembling). Bei großen VLAs geht LeRobot einen Schritt weiter, mit asynchroner Inferenz: Während der Arm den aktuellen Chunk abfährt, rechnet das Modell schon den nächsten.
synchron:    [rechnen][fahren 50][rechnen][fahren 50][rechnen] …   Arm steht beim Rechnen
asynchron:   [rechnen][fahren 50 ················][fahren 50 ······] …
                       [rechnen nächsten Chunk]   [rechnen …]       Arm fährt durch
Laut Hugging Face war SmolVLA damit rund 30 Prozent schneller (9,7 statt 13,75 Sekunden pro Aufgabe) und schaffte im gleichen Zeitfenster 19 statt 9 Würfel. Man kann Modell und Roboter dabei sogar auf verschiedene Rechner verteilen – Seeed warnt aber zu Recht, dass die gRPC-Verbindung dafür nicht authentifiziert ist und nur über VPN oder SSH-Tunnel laufen sollte. In LeRobot 0.6 ist Real-Time Chunking (--inference.type=rtc) der Nachfolger dieses Ansatzes.
Gute Demonstrationen: worauf es ankommt
Die Qualität des Datensatzes entscheidet mehr über den Erfolg als die Wahl der Policy. Die Empfehlungen aus der LeRobot-Doku, dem Hugging-Face-Blog und Seeeds Anleitung:
- Mindestens 50 Episoden, etwa zehn pro Objektposition. SmolVLA wurde mit 25 ausdrücklich als „not enough" beschrieben.
- Kameras fest montieren. Eine Kamera, die zwischen Aufnahme und Ausführung um einen Zentimeter verrutscht, sieht eine andere Welt.
- Zwei Kameras als pragmatischer Standard: eine von oben oder vorn für den Überblick, eine am Handgelenk oder seitlich für die Feinarbeit. 640 × 480 bei 30 fps reicht.
- Gleichmäßiges, neutrales Licht. Keine Farbstiche, konstante Belichtung, kein Sonnenlicht, das im Tagesverlauf wandert.
- Leader-Arm und Hände aus dem Bild halten, ruhiger Hintergrund.
- Konsistent vormachen. Immer dieselbe Greifstrategie, Variation nur schrittweise steigern. Faustregel aus der Doku: Du solltest die Aufgabe selbst nur anhand der Kamerabilder lösen können.
- Kameras nach Ort benennen (
top,wrist), nicht nach Gerät. Die Namen müssen bei der Ausführung exakt zum Training passen, sonst hilft--rename_map. - Aufgabe sinnvoll beschreiben, 25 bis 50 Zeichen, nicht „task1" – VLAs lernen aus diesem Text.
- Schlechte Episoden sofort neu aufnehmen (
r), statt sie im Datensatz zu lassen. - Datenaugmentation vorsichtig: Helligkeit und Kontrast nur leicht variieren, etwa 0,9 bis 1,1, und nur im Training.
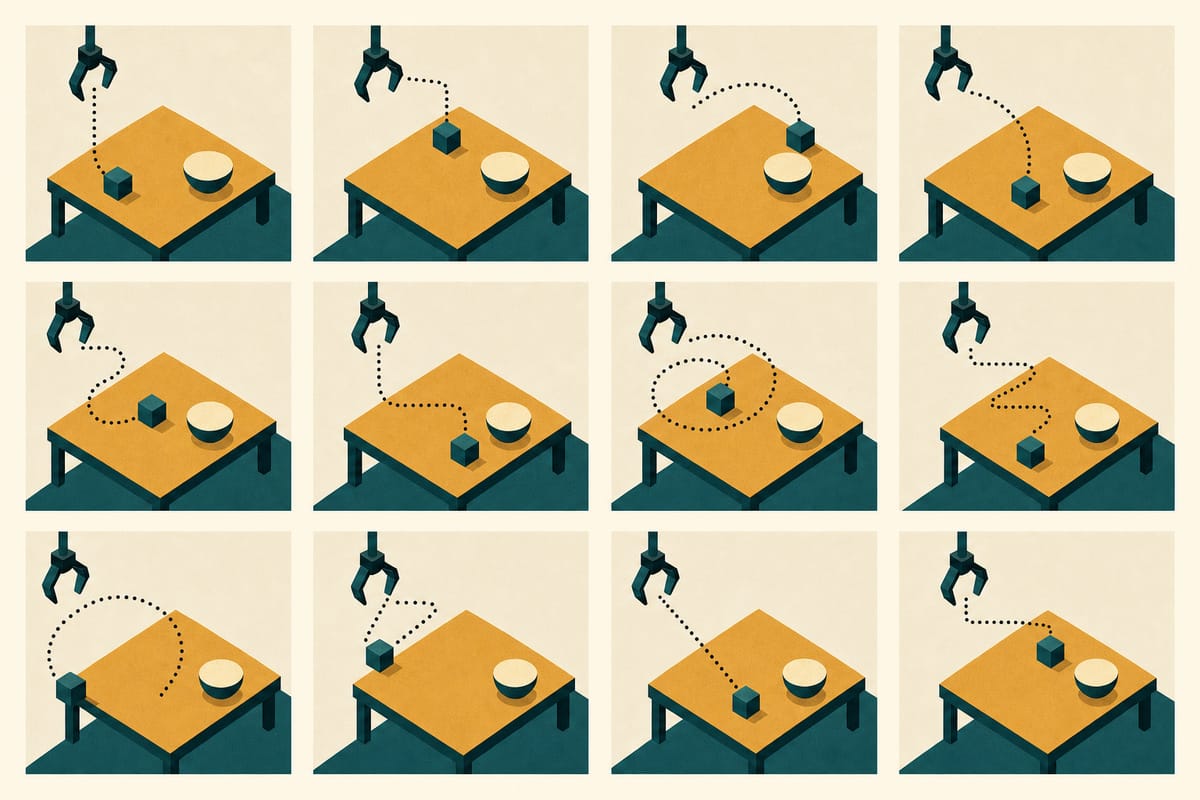
Raster aus zwölf kleinen Kacheln, jede zeigt denselben Tisch mit Würfel und Schale; der Würfel liegt auf jeder Kachel an einer anderen Stelle, und eine gepunktete Linie zeigt jeweils einen anderen Weg des Greifers
So sieht ein guter Datensatz aus: dieselbe Aufgabe, aber der Würfel liegt jedes Mal etwas anders. Aus dieser Variation lernt die Policy, sich an die Situation anzupassen.
Ein Fehlerbild, das man kennen sollte: π0.5 und MolmoAct2 erwarten Quantil-Statistiken im Datensatz. Bei älteren Datensätzen gibt es einen ValueError; lerobot-edit-dataset --operation.type recompute_stats behebt das.
Imitation Learning oder klassische Programmierung?
Beide Ansätze schließen sich nicht aus – sie lösen verschiedene Probleme. Der Vergleich:
| Kriterium | Klassisch (Posen, Bahnen, Sequenzen) | Imitation Learning |
|---|---|---|
| Objekt immer an derselben Stelle | ideal, präzise und vorhersagbar | unnötig aufwendig |
| Objekt liegt jedes Mal anders | scheitert ohne Bildverarbeitung | Stärke |
| Weiche, verformbare Objekte | sehr schwer | gut |
| Reproduzierbarkeit, Nachweis | hoch | statistisch (Erfolgsquote) |
| Aufwand pro neuer Aufgabe | Teaching, Minuten bis Stunden | 50+ Demos + Training |
| Hardware | Rechner ohne GPU | GPU für Training, oft auch Inferenz |
| Sicherheitsgrenzen | explizit im Code | müssen zusätzlich programmiert werden |
Der letzte Punkt ist mir wichtig: Eine Policy weiß nichts von Gelenkgrenzen, Tischebenen oder Momentengrenzen. Alles, was ich im Steuerungsartikel über Folgefehler, Freeze und Watchdog geschrieben habe, gilt hier genauso – es muss nur unterhalb der Policy sitzen. Die Policy schlägt Bewegungen vor, die Sicherheitsschicht entscheidet, ob sie ausgeführt werden.
Häufige Fragen
Was ist ein Vision-Language-Action-Modell? Ein neuronales Netz, das Kamerabilder, eine Anweisung in natürlicher Sprache und den Zustand des Roboters verarbeitet und daraus direkt Steuerbefehle für die Motoren erzeugt. Technisch ist es meist ein vortrainiertes Bild-Sprach-Modell mit einem angehängten Action-Experten.
Wie viele Demonstrationen braucht ein Roboter, um eine Aufgabe zu lernen? Als Faustregel etwa 50 Episoden, rund zehn pro Objektposition. Mit 25 Episoden war das Ergebnis bei SmolVLA laut Doku nicht ausreichend. Vortrainierte VLAs kommen bei einfachen Aufgaben mit weniger aus als von Grund auf trainierte Policies.
Welche Grafikkarte brauche ich für LeRobot? Für ACT reicht eine Consumer-GPU mit 6 bis 8 GB, das Training dauert auf einer RTX 4090 unter einer Stunde. SmolVLA läuft mit rund 2 GB in der Inferenz, für das Training ist eine Cloud-GPU sinnvoll. π0, GR00T und MolmoAct2 brauchen fürs Training 24 bis 80 GB.
Was kostet ein Roboterarm für LeRobot? Der SO-101 kostet als Teileliste rund 226 Euro für Leader und Follower zusammen. Stabilere Arme wie der reBot B601-RS mit 48-V-Servomotoren liegen bei rund 1.500 US-Dollar ohne Leader-Arm und Netzteil.
Kann ich LeRobot ohne echten Roboter ausprobieren?
Ja. lerobot-eval enthält mehrere Simulationsumgebungen wie LIBERO und Meta-World, und auf dem Hugging Face Hub liegen viele fertige Datensätze, mit denen man Training und Auswertung üben kann.
Ist LeRobot für den produktiven Einsatz geeignet? Für Forschung, Prototypen und Lehre ja. Für produktive Anwendungen fehlen die Garantien klassischer Steuerungen: Eine Policy hat eine Erfolgsquote, keine Zusicherung. Sicherheitsgrenzen und Überwachung müssen zusätzlich implementiert werden.
Was ist der Unterschied zwischen ACT und SmolVLA? ACT ist eine kleine Policy ohne Sprachverständnis, die für jede Aufgabe neu trainiert wird. SmolVLA ist auf vielen Datensätzen vortrainiert, versteht Anweisungen in Text und verallgemeinert besser, braucht aber mehr Rechenleistung beim Training.
Zusammenfassung und praktische Tipps
- Vormachen statt programmieren. Imitation Learning lernt aus Demonstrationen, wie Bild und Stellung in Bewegung übersetzt werden.
- Leader-Follower ist der Standard. Ein kleiner Arm in der Hand steuert den Roboter, alles wird gleichzeitig aufgezeichnet.
- LeRobot 0.6 deckt den ganzen Ablauf ab:
lerobot-calibrate,-teleoperate,-record,-train,-rollout. - Mit ACT anfangen. Klein, schnell trainiert, läuft auf Consumer-GPUs, gute Ergebnisse mit rund 50 Demos.
- SmolVLA als erstes VLA. 450 Millionen Parameter, versteht Anweisungen, schlägt im Paper größere Modelle auf Low-Cost-Armen.
- Große VLAs nur mit passender Hardware. π0, GR00T, MolmoAct2 brauchen fürs Training 24 GB und mehr.
- Datensatzqualität schlägt Modellwahl. Feste Kameras, gleichmäßiges Licht, konsistente Demonstrationen.
- Action Chunking und asynchrone Inferenz machen große Modelle auf echter Hardware erst flüssig.
- Kalibrierung und Kameranamen müssen zwischen Aufnahme und Ausführung identisch sein.
- Sicherheit gehört unter die Policy. Grenzen, Folgefehler und Freeze gelten weiter.
Mein Rat: Fang nicht mit dem größten Modell an, sondern mit der einfachsten Aufgabe – ein Würfel, eine Schale, zwei feste Kameras, 50 saubere Demos, ACT. Wenn das funktioniert, verstehst du, wie empfindlich das Ergebnis auf Licht, Kameraposition und Konsistenz reagiert, und genau dieses Gefühl brauchst du, bevor sich ein VLA lohnt. Und behalte die klassische Steuerung im Werkzeugkasten: Für alles, was immer an derselben Stelle liegt, ist eine geteachte Bahn präziser, schneller und nachvollziehbarer als jedes neuronale Netz. Die interessantesten Aufbauten kombinieren beides – eine programmierte Anfahrt in die Nähe des Ziels und eine gelernte Policy für die letzten Zentimeter.
Ressourcen
- LeRobot auf GitHub – Quellcode, unterstützte Hardware, Plugins
- LeRobot v0.6.0: Imagine, Evaluate, Improve – offizielle Release-Ankündigung
- LeRobot-Doku: Imitation Learning auf echten Robotern – der komplette Ablauf mit allen Kommandos
- LeRobot-Doku: Hardware-Leitfaden – VRAM und Trainingszeiten je Policy
- LeRobotDataset v3.0 – das Datenformat im Detail
- SmolVLA – Paper und SmolVLA – Blog – Architektur, Benchmarks, asynchrone Inferenz
- π0 – Paper – das Referenzmodell für VLAs mit Flow Matching
- ACT / ALOHA – Paper – Action Chunking with Transformers
- GR00T N1.7 – Modellkarte – NVIDIAs Robotik-Foundation-Model
- MolmoAct2 – Modellkarte – offenes VLA vom Allen Institute for AI
- LeRobot-Doku: Datensätze guter Qualität – Licht, Kameras, Aufgabenbeschreibungen
- Seeed Wiki: LeRobot mit dem reBot Arm B601-RS – Installation, Kalibrierung, Aufnahme für die RS-Variante
- SO-ARM100 / SO-101 auf GitHub – Bauanleitung und Stückliste des günstigen Einstiegsarms
- Einen Roboterarm per Software steuern – die klassische Steuerung als Grundlage und Sicherheitsschicht
- KI, maschinelles Lernen, Deep Learning – die Begriffe sauber getrennt
- Transformer-Architektur – wie die Sprachmodelle in VLAs aufgebaut sind