
Gemini 4 Carbon: Das beste KI-Modell der Welt – und du darfst es nicht benutzen
Artikel-Übersicht
Am 28. Oktober 2026 hat Google DeepMind Gemini 4 Carbon vorgestellt, nur zwei Wochen nach dem Vorgänger Gemini 4 Argon. Die Ankündigung bringt alles mit, was eine Schlagzeile braucht: Platz 1 in einem viel beachteten unabhängigen KI-Index, Bestwerte beim Finden von Sicherheitslücken – und einen Haken. Benutzen darf das Modell fast niemand. Zugang haben ausgewählte Cyber-Verteidiger, alle anderen warten auf ein „so bald wie möglich" ohne Datum.
Dieser Artikel prüft die Zahlen hinter dem ersten Platz, zeigt, wo Carbon verliert, erklärt einen scheinbaren Widerspruch bei den Halluzinationen und ordnet die Sperre ein: Carbon ist nach Anthropics Claude Mythos das zweite Spitzenmodell, das wegen seiner Hacking-Fähigkeiten zuerst nur an Verteidiger geht. Zum Schluss geht es darum, was du jetzt planen solltest.
Grundlage sind Googles Ankündigung, die Messungen von Artificial Analysis und die Berichte von VentureBeat und Tom's Hardware, alle abgerufen am 4. November 2026. Wie sich die großen Anbieter generell aufstellen, steht im Vergleich der LLM-Anbieter 2026; wie man eine Preisankündigung auf die echte Rechnung herunterbricht, zeigt der Faktencheck zu GPT-6.1 Terra.
Was Google angekündigt hat
Carbon ist laut Google „unser stärkstes Modell" mit Spitzenwerten in Cybersicherheit und bei langen, mehrstufigen Aufgaben. So formuliert es Koray Kavukcuoglu, Chief AI Architect bei Google DeepMind, im Ankündigungsbeitrag. Intern, schreibt er, habe man Carbon „tagelang" an großen Codebasen arbeiten sehen.
Der Takt ist bemerkenswert. Argon ging am 30. September 2026 an Fairwind-Teilnehmer und wurde am 13. Oktober breit freigegeben. Carbon folgte 15 Tage später. Einen technischen Bericht, eine Architekturbeschreibung oder eine Parameterzahl hat Google nicht veröffentlicht. Die technischen Eckdaten, die bekannt sind, stammen von Artificial Analysis: Kontextfenster 1 Million Token, Eingabe als Text, Bild, Video und Sprache, Ausgabe als Text.
Wer Carbon nutzen darf und wer nicht
Stand 4. November 2026 kannst du Carbon weder in der Gemini-App noch über die API nutzen. Google verteilt den Zugang in Stufen:
┌─────────────────────────────┐
│ 1. Teilgruppe geprüfter     │  ← seit 28.10.2026
│    Cyber-Verteidiger        │
└──────────────┬──────────────┘
               ▼
┌─────────────────────────────┐
│ 2. weitere vertrauenswürdige│  ← schrittweise, ohne Datum
│    Partner (Fairwind)       │
└──────────────┬──────────────┘
               ▼
┌─────────────────────────────┐
│ 3. Entwickler, Unternehmen, │  ← „so bald wie möglich"
│    Endkunden                │
└─────────────────────────────┘
Bevor Stufe 3 kommt, will Google Rückmeldungen sammeln und die Guardrails nachschärfen. Außerdem nimmt das Modell am freiwilligen Vorabtest der US-Regierung teil. Artificial Analysis führt Carbon ausdrücklich als Modell ohne öffentlich verfügbare API. Varun Mohan, der bei Google die Entwicklungsumgebung Antigravity verantwortet, kündigte an, der Zugang werde zunächst über Fairwind wachsen und erst danach in Antigravity kommen – ebenfalls ohne Datum.
Wann es so weit ist, weiß niemand außerhalb von Google. Auf der Prognoseplattform Polymarket setzten Händler am 3. November die höchste Wahrscheinlichkeit auf eine Freigabe um den 10. und 11. November. Das ist Stimmung, keine Information.
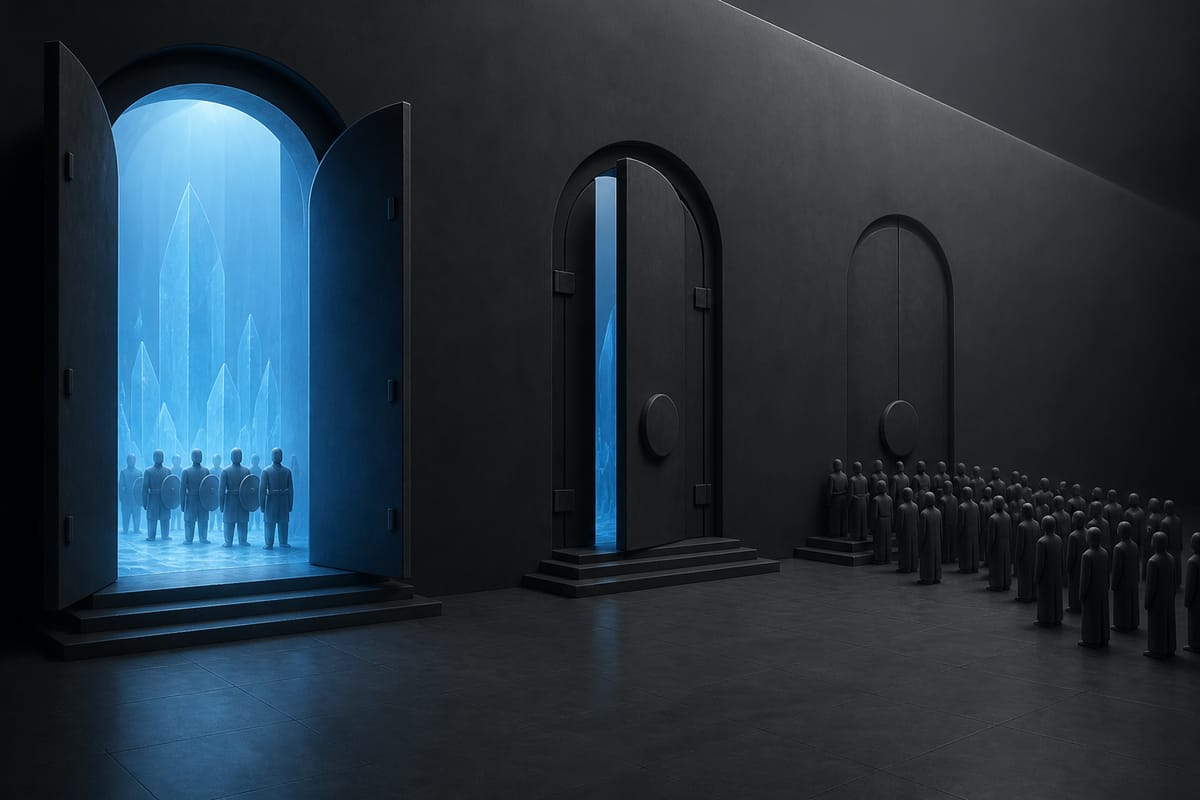
Eine dunkle Halle mit drei Toren in Reihe: Das erste steht weit offen und ist blau erleuchtet, dahinter stehen wenige Figuren mit Schilden. Das zweite ist nur einen Spalt geöffnet, das dritte geschlossen, davor wartet eine lange Schlange gesichtsloser Figuren.
Drei Tore, drei Stufen: Die Verteidiger sind drin, die Partner kommen nach und nach, alle anderen warten vor verschlossener Tür.
Platz 1, aber knapp
Der erste Platz ist echt, aber er beträgt einen Punkt. Im Intelligence Index v5 von Artificial Analysis, gemessen mit hoher Reasoning-Stufe, kommt Carbon auf 59 Punkte. Claude Opus 5.5 liegt bei 58, GPT-6 Astra bei 57, der Vorgänger Argon bei 50. Auf der Modellseite von Artificial Analysis steht am 4. November für die Variante „High" bereits eine 60.
Zwei Dinge relativieren das. Erstens: Unsicherheitsbereiche veröffentlicht weder Google noch der Index. Ein Abstand von einem Punkt sagt über deine konkrete Aufgabe wenig. Zweitens beruhen laut Latent Space rund 60 Prozent des neuen Index auf privaten Testsätzen. Das schützt vor Training auf den Testfragen, macht die Werte aber auch schwer nachprüfbar.
Googles eigene Tabelle mit 17 Benchmarks zeigt Carbon in 15 Zeilen vorn. Das ist eine Auswahl des Herstellers. Interessanter sind die Zeilen, in denen Carbon nicht vorn liegt.
Wo Carbon verliert
Gerade beim agentischen Programmieren – dem Einsatz, für den viele Leser dieses Blogs ein Modell suchen – liegt Carbon hinter Anthropic. Die wichtigsten Abstände:
| Benchmark | Gemini 4 Carbon | Bester Konkurrent |
|---|---|---|
| AA Coding Agent Index | 59 (Antigravity CLI) | 62 (Claude Code mit Opus 5.5) |
| FrontierCode v1.1 | 51 % | 56 % (Opus 5.5) |
| FrontierSWE 2 | 61,2 % | 65,5 % (GPT-6 Astra) |
| OSWorld-2.1, Offline-Teil | 81,5 % | 87,2 % (Opus 5.5) |
| AA-Briefcase (Elo) | 1.609 | 1.678 (Kimi K3.1 Pro) |
Quellen: VentureBeat und Artificial Analysis, Stand 28. Oktober bis 4. November 2026.
Dazu kommt: Die Coding-Werte von Carbon wurden nur in Googles eigener Umgebung Antigravity CLI gemessen. Wie das Modell in anderen Agenten-Werkzeugen abschneidet, ist offen. Wer wissen will, welche Werkzeuge mit welchen Modellen arbeiten, findet das im Überblick über KI-Coding-Assistenten.
Das Halluzinations-Paradox
Google meldet halb so viele unbelegte Aussagen wie bei Argon, Artificial Analysis misst eine fast dreimal so hohe Halluzinationsrate – und beide Zahlen können stimmen.
Der Wert von Artificial Analysis stammt aus AA-Omniscience, einem Wissenstest. Dort beantwortet Carbon 58 Prozent der Fragen richtig, Argon nur 48 Prozent. Die Halluzinationsrate misst etwas anderes: wie oft ein Modell eine falsche Antwort gibt, statt einzuräumen, dass es etwas nicht weiß. Sie steigt von 4 Prozent bei Argon auf 11 Prozent bei Carbon. Das Modell weiß also mehr, rät aber auch öfter, wenn es nichts weiß.
Googles Zahl stammt aus internen Tests zu „unbelegten Behauptungen". Das ist eine andere Messung mit anderen Aufgaben, und sie ist nicht unabhängig geprüft.
Die Einordnung ist wichtig: 11 Prozent sind immer noch der zweitbeste gemessene Wert, hinter Argon. Opus 5.5 und GPT-6 Astra liegen auf demselben Test bei je 50 Prozent. Gegenüber dem Vorgänger ist Carbon ein Rückschritt, gegenüber der Konkurrenz nicht. Die Überschrift von Tom's Hardware, Carbon sei am wenigsten anfällig für Halluzinationen, trifft also nur im Vergleich mit anderen Herstellern zu – nicht mit Googles eigenem Vorgänger.
Die Cyber-Werte und ihr Kleingedrucktes
Die Cyber-Benchmarks sind der Grund für die Sperre, und sie sind nicht unabhängig bestätigt. Google meldet:
| Aufgabe | Benchmark | Argon | Carbon |
|---|---|---|---|
| Lücken finden | SEC-bench Pro | 83,4 % | 88,2 % |
| Lücken ausnutzen | ExploitGym | 42,0 % | 54,8 % |
| Lücken schließen | CWE-bench | 68,0 % | 71,0 % |
Google sagt selbst, die externen Cyber-Tests liefen „ohne Guardrails". Im Klartext: Die Werte zeigen, was das nackte Modell kann, nicht, was ein Kunde später bekommt. Der Sprung bei ExploitGym um fast 13 Punkte ist der heikle Teil. Ein Modell, das Lücken nicht nur findet, sondern verlässlich ausnutzt, ist für Angreifer genauso nützlich wie für Verteidiger.
Auf der Habenseite meldet Google beim Gray-Swan-Test für indirekte Prompt Injection 0,0 Prozent erfolgreiche Angriffe, nach 0,7 Prozent bei Argon. Auch das ist eine Herstellerangabe.
Das Muster: zu gefährlich zum Veröffentlichen
Carbon ist kein Einzelfall, sondern das zweite Spitzenmodell in sieben Monaten, das zuerst nur an Verteidiger geht. Den Anfang machte Anthropic am 7. April 2026 mit Claude Mythos Preview und dem Programm Project Glasswing.
| Claude Mythos Preview | Gemini 4 Carbon | |
|---|---|---|
| Vorgestellt | 7. April 2026 | 28. Oktober 2026 |
| Programm | Project Glasswing | Fairwind |
| Zugang zum Start | 12 namentlich genannte Partner und über 40 weitere Organisationen | Teilgruppe geprüfter Cyber-Verteidiger |
| Allgemeine Verfügbarkeit | „We do not plan to make Claude Mythos Preview generally available." | „so bald wie möglich" |
| Öffentlicher Preis | – | ja, 2/10 Dollar pro Million Token zur Einführung |
Der Unterschied steckt in der letzten Zeile. Anthropic hat Mythos als Forschungsvorschau ohne Verkaufsabsicht positioniert. Google nennt für Carbon Preise, Benchmarks und einen Platz in der Rangliste, ohne dass jemand es kaufen kann. Kritiker sprechen deshalb von einem „Showroom-Modell", Ars Technica titelte vom Spitzenmodell, „das du nicht benutzen kannst".
Beides kann gleichzeitig stimmen: Eine gestaffelte Freigabe gibt Verteidigern einen Vorsprung, um Lücken zu schließen, bevor Angreifer dasselbe Werkzeug haben. Und sie erlaubt es, die Spitzenposition zu beanspruchen, bevor die Öffentlichkeit eigene Tests fahren kann.
Zwei schwere, verschlossene Tresore auf einem Mauersockel, aus den Türfugen dringt blaues Licht. Davor flicken kleine Figuren mit Kelle und Steinen Risse in der Mauer.
Zwei Modelle unter Verschluss, ihr Nutzen fließt an die, die Lücken schließen: das Muster hinter Mythos und Carbon.
Preise und was eine Aufgabe wirklich kostet
Zum Start kostet Carbon genauso viel wie Argon, danach das Doppelte.
| Einführungspreis | danach | |
|---|---|---|
| Input pro Million Token | 2 $ | 4 $ |
| Output pro Million Token | 10 $ | 20 $ |
| Cache-Rabatt auf Input | 95 % | – |
| Ende der Einführungsphase | Carbon: nicht genannt · Argon: 30. November 2026 |
Der Preis pro Token sagt wenig über die Rechnung. Aussagekräftiger ist, was eine Aufgabe kostet. Artificial Analysis rechnet für eine Aufgabe aus dem Intelligence Index bei Carbon mit 7,76 Dollar, bei Opus 5.5 mit 10,04 Dollar und bei GPT-6 Astra mit 6,25 Dollar. Carbon erzeugt dabei im Schnitt 123.000 Output-Token pro Aufgabe, 29 Prozent weniger als Opus. Ein Tempo-Monster ist es nicht: 67 Token pro Sekunde und rund 65 Sekunden bis zum ersten Token der Antwort, weil das Modell zuerst lange denkt. Was dieses Denken kostet, erklärt der Artikel über Reasoning-Modelle.
Was das für dich heißt
Plane mit dem, was verfügbar ist – und das ist Argon, nicht Carbon. Konkret:
- Preisänderung zum 1. Dezember 2026 einplanen: Wer Argon zum Einführungspreis nutzt, zahlt ab dann das Doppelte. Budgets und Kostenalarme jetzt anpassen.
- Nicht auf Carbon warten: Es gibt keinen Termin. Ein Projekt, das ein bestimmtes Modell voraussetzt, ist ein Projekt mit unbekanntem Starttermin.
- Austauschbar bauen: Modellname und Endpunkt als Konfiguration, nicht im Code. Dann ist ein Wechsel ein Einzeiler, wenn Carbon kommt.
- Eigene Tests statt Rangliste: Ein Punkt Vorsprung im Index entscheidet nichts. Zwanzig echte Aufgaben aus deinem Alltag schon.
- Halluzinationen gezielt testen: Bei Wissensfragen ohne Quellen ist Carbon messbar riskanter als Argon. Für solche Fälle Retrieval und Quellenpflicht einbauen.
- Kosten pro Aufgabe messen, nicht pro Token – die Strategien dafür stehen in LLM-Kosten optimieren.
Häufige Fragen
Kann ich Gemini 4 Carbon schon nutzen? Nein, nicht ohne Einladung. Stand 4. November 2026 ist Carbon nur für ausgewählte Cyber-Verteidiger im Fairwind-Programm freigeschaltet. Gemini-App und öffentliche API bieten es noch nicht an.
Wann kommt Gemini 4 Carbon für alle? Google nennt keinen Termin, nur „so bald wie möglich". Zuvor will das Unternehmen Rückmeldungen sammeln und die Guardrails verbessern. Prognosemärkte erwarten die Freigabe Mitte November, aber das ist Spekulation.
Ist Gemini 4 Carbon besser als Claude Opus 5.5? Im Gesamtindex von Artificial Analysis um einen Punkt, 59 zu 58. Beim agentischen Programmieren liegt Opus 5.5 vorn, im Coding Agent Index mit 62 zu 59. Für Wissensfragen hat Carbon den höchsten Omniscience-Wert und eine deutlich niedrigere Halluzinationsrate als Opus.
Was kostet Gemini 4 Carbon? Zur Einführung 2 Dollar pro Million Input-Token und 10 Dollar pro Million Output-Token, danach 4 und 20 Dollar. Wann die Einführungsphase endet, hat Google nicht gesagt.
Warum halluziniert Carbon mehr als Argon? Carbon beantwortet mehr Fragen richtig, rät aber auch öfter, wenn es die Antwort nicht kennt. Artificial Analysis misst eine Halluzinationsrate von 11 Prozent gegenüber 4 Prozent bei Argon. Im Vergleich mit Opus 5.5 und GPT-6 Astra, beide bei 50 Prozent, ist das trotzdem ein guter Wert.
Warum gibt Google sein bestes Modell nicht frei? Offiziell wegen der Cyber-Fähigkeiten: Carbon findet und nutzt Sicherheitslücken deutlich besser als der Vorgänger. Verteidiger sollen einen Vorsprung bekommen, bevor das Modell allgemein verfügbar ist.
Zusammenfassung und praktische Tipps
- Platz 1 mit einem Punkt: 59 gegen 58 im Intelligence Index v5, ohne Unsicherheitsangaben.
- Gesperrt: Nur Cyber-Verteidiger im Fairwind-Programm, keine öffentliche API, kein Termin.
- Beim Coding hinten: Opus 5.5 führt im Coding Agent Index mit 62 zu 59, GPT-6 Astra bei FrontierSWE.
- Mehr Wissen, mehr Raten: Halluzinationsrate von 4 auf 11 Prozent gestiegen, aber weit unter der Konkurrenz.
- Cyber-Werte ohne Guardrails: SEC-bench Pro 88,2 Prozent, ExploitGym 54,8 Prozent, nicht unabhängig geprüft.
- Zweiter Fall nach Mythos: Gestaffelte Freigabe an Verteidiger wird zum Muster bei Spitzenmodellen.
- Preis verdoppelt sich später: 2/10 Dollar zur Einführung, danach 4/20 Dollar.
- Argon wird teurer: Ab 1. Dezember 2026 gilt der volle Preis.
- Kosten pro Aufgabe zählen: 7,76 Dollar bei Carbon gegenüber 10,04 Dollar bei Opus 5.5 im Index.
Mein Rat: Behandle Carbon wie ein angekündigtes Produkt, nicht wie ein verfügbares. Eine Rangliste, auf der ein Modell steht, das niemand testen kann, ist Marketing mit Messwerten – auch wenn die Messwerte stimmen. Die eigentliche Nachricht für die meisten Teams ist unspektakulär: Argon kostet ab Dezember das Doppelte, und wer seine Modellwahl nicht austauschbar gebaut hat, merkt das jetzt. Wenn Carbon freigegeben ist, teste es an deinen eigenen Aufgaben. Vorher lohnt sich das Warten nicht.
Ressourcen
- Introducing Gemini 4 Carbon – Googles Ankündigung vom 28. Oktober 2026 mit Benchmarks, Preisen und Zugangsstufen, abgerufen am 4. November 2026.
- Gemini 4 Carbon bei Artificial Analysis – unabhängige Messwerte zu Index, Preis, Tempo und Kosten pro Aufgabe.
- Google unveils Gemini 4 Carbon (VentureBeat) – Carl Franzen, 28. Oktober 2026, mit vollständiger Benchmark- und Preistabelle.
- Google reveals new Gemini 4 Carbon AI model (Tom's Hardware) – Einordnung des Abstands zu Opus 5.5 und der Halluzinationswerte.
- AINews: Gemini 4 Carbon (Latent Space) – Sammlung unabhängiger Evaluationen und Reaktionen aus der Szene.
- Project Glasswing (Anthropic) – die Vorlage für gestaffelte Freigaben: Claude Mythos Preview seit 7. April 2026.
- Gemini 4 Carbon tops the charts. You still can't use it. – die „Showroom-Modell"-Kritik, 1. November 2026.
- Die führenden LLM-Anbieter 2026 im großen Vergleich – wie sich Google, Anthropic und OpenAI insgesamt aufstellen.
- GPT-6.1 Terra im Faktencheck – dieselbe Rechnung für OpenAIs günstiges Modell.
- Reasoning-Modelle erklärt – warum lange Denkphasen Tempo und Kosten treiben.
- KI-Coding-Assistenten: welches Werkzeug wofür – die Werkzeuge, in denen sich Coding-Werte in der Praxis zeigen.
- LLM-Kosten optimieren – acht Strategien gegen die steigende API-Rechnung.